2020-12-31

不打了?曝郭艾伦因伤缺席跨年大战 江苏爆冷辽宁的机会来了?_郭少

原标题:不打了?曝郭艾伦因伤缺席跨年大战 江苏爆冷辽宁的机会来了?

北京时间12月31日,CBA将迎来跨年大战,辽宁队迎战江苏队。凭借着一波7连胜势头,辽宁队还能否继续乘胜追击呢?不过,在赛前却传来了一个不利的消息,郭艾伦将因伤缺阵与江苏队的比赛。在没有韩德君和郭艾伦双核的情况下,辽宁队会被意外爆冷门吗?

辽宁队是目前CBA联盟中最炙手可热的球队——没有之一。凭借着一波7连胜,辽宁队以21胜2负,力压卫冕冠军广东队,排在积分榜第1位。而江苏队的近况则非常糟糕,球队已经遭遇6连败,目前以5胜19负,排在第16位。

如果从双方近况和实力上来讲,辽宁队其实是占据压倒性优势的。不过,在这一战中,韩德君恐怕将继续缺阵。而目前据最新消息,球队另外一名核心球员郭艾伦也将因伤缺阵,尽管郭少的伤势并不严重,不过,出于安全期间,辽宁队还是选择让郭艾伦轮休。

郭艾伦是在上一战比赛中受伤的,手肘受了点小伤。尽管伤势并无大碍,不过,或许是考虑到江苏队的实力一般,辽宁队最终还是选择让郭少轮休。

尽管辽宁队在纸面实力上占优,不过,老话常说,骄兵必败,况且,CBA无弱旅。尽管江苏队实力一般,可毕竟他们曾经也是联盟顶尖的球队之一。终使实力一般,但拼劲却还在。尤其是在韩德君和郭少双双缺席的情况下,他们更是嗅到了爆冷门的机会。返回搜狐,查看更多

责任编辑:

原文转载:http://sport.shaoqun.com/a/380162.html

跨境电商:https://www.ikjzd.com/

马士基航运:https://www.ikjzd.com/w/1296

海维:https://www.ikjzd.com/w/1891


原标题:不打了?曝郭艾伦因伤缺席跨年大战江苏爆冷辽宁的机会来了?北京时间12月31日,CBA将迎来跨年大战,辽宁队迎战江苏队。凭借着一波7连胜势头,辽宁队还能否继续乘胜追击呢?不过,在赛前却传来了一个不利的消息,郭艾伦将因伤缺阵与江苏队的比赛。在没有韩德君和郭艾伦双核的情况下,辽宁队会被意外爆冷门吗?辽宁队是目前CBA联盟中最炙手可热的球队——没有之一。凭借着一波7连胜,辽宁队以21胜2负,力压卫
wish:wish
贝贝母婴网:贝贝母婴网
3分钟内,这份2020亚马逊运营爆单秘诀将刷爆朋友圈!:3分钟内,这份2020亚马逊运营爆单秘诀将刷爆朋友圈!
10月底的米亚罗,正好赏红叶 :10月底的米亚罗,正好赏红叶
佛山暑期带孩子去哪玩?金银岛水城暑期要门票吗?:佛山暑期带孩子去哪玩?金银岛水城暑期要门票吗?

Wish:01/11正式放出:产品视频展示方式,定了!

Wish:01/11正式放出:产品视频展示方式,定了!

2021年1月11日(太平洋时间)起,各位商户上传的产品演示视频,通过审核的视频,将正式向Wish APP的全球安卓手机用户展示!

虽然产品演示视频还没有正式向全球消费者展示,但是商户们都很关心视频更具体的细节,小编也收集了一些热门问题,帮助大家更清晰地了解并使用产品演示视频功能。

产品演示视频是如何呈现的?

已经通过审核的商户提交的产品演示视频,将会在Wish APP端向全球消费者展示(目前仅有安卓手机用户可以看到)。展示位置为产品详情页面的首图位置,详情页原有的首图将顺延至二图,而在APP瀑布流中,依然展示的是产品的首图(而非产品演示视频)

产品演示视频在Wish APP端的展示示例:

image.png

为什么没有看到我上传的视频?

2021年1月11日(太平洋时间),如果你没有在前端看到自己上传的视频,原因可能有以下几种:

目前,产品演示视频只在安卓手机端的Wish APP上向全球用户展示,iOS手机及网页端的展示工作仍在推进中,Wish将会尽快实现产品演示视频在所有渠道的部署。

因为产品演示视频的数量较多,虽然视频正式向用户展示的时间是从2021年1月11日(太平洋时间)开始,但当天不一定能向全部安卓手机用户进行展示部署,全部的展示部署将会在几天内完成,不要着急哦~若您在1月11日(太平洋时间)没有看到您的产品视频,建议您可以稍后再次查看。

为确保产品演示视频的内容符合平台相关规范及各国各地区的法规要求,Wish对所有上传的产品视频均会进行一定的审核,只有审核通过后的产品演示视频才会在用户端进行展示。若您的产品视频不符合相关规范,审核将不通过,也就无法在前端展示。若您上传的产品视频长时间没有在前端展示,建议您可以重新上传新的产品视频,并确保视频符合相关规范。

我应该如何充分利用产品演示视频?

产品演示视频对于每一位商户来说都是提升产品服务的一次机遇,通过产品视频可以更好、更直观地展示的外观、尺寸,更清晰地说明产品的使用方式等,也能帮助产品销售的提升。

产品演示视频是更生动的展示产品的方式,我们建议商户可以通过视频讲述产品的故事(比如产品的质量、品牌的价值等),用简短有趣的方式展示人性化的内容(比如能够引起用户情感共鸣),当然,通过视频充分展示产品是如何解决用户的问题也是非常有效的视频内容。

产品演示视频对于用户的购物体验来说是个很大的提升,因此,建议各位商户在上传新产品的时候,就同时上传优质的产品演示视频

虽然产品演示视频相比而言能够更清晰地展示产品,但是,在Wish APP首页瀑布流中,系统展示的依然是产品的主图,因此主图依然是非常重要的产品展示形式。各位商户要有效协调主图与产品演示视频之间的协作

需要特别提醒的是,因为视频展示给用户的时候是没有声音的,所以,建议各位商户不要拍摄各类结合音乐的视频内容,也不要在视频中通过语言去对产品进行描述和解释(因为观看视频的人也听不到……);同时不同国家有不同的文化习惯,在拍摄视频的时候要避免碰触各个国家的禁忌。

如何为产品上传演示视频?演示视频要注意些什么?

关于如何上传产品演示视频,及视频的格式、大小、内容要求等,请点击此处进行查看。

产品演示视频即将向全球用户展示,你的产品将会以更加生动的形象出现在Wish上,对你的产品销售也会有很好的帮助哦~你还在等什么?赶快继续上传产品演示视频,为2021年开个好头!


文章来源:https://www.ikjzd.com/home/139160

跨境电商:https://www.ikjzd.com/

笨鸟转运:https://www.ikjzd.com/w/1550

菜鸟网:https://www.ikjzd.com/w/1547

五洲会海购:https://www.ikjzd.com/w/1068

Wish:01/11正式放出:产品视频展示方式,定了!

2021年1月11日(太平洋时间)起,各位商户上传的产品演示视频,通过审核的视频,将正式向Wish APP的全球安卓手机用户展示!

在社交媒体平台上营销,卖家如何有效使用模因

各类网络流行语层出不穷,在社交平台上更是广泛传播,这也引起了各位卖家的关注,纷纷在社交媒体平台上用起了模因,也就是所谓的"梗",来蹭一波热度。


虽然模因制作起来并不难,但应用模因也是需要一些计划数字化营销专家Neil Patel分享了一些技巧可以使您的模因具有可关联性可共享性,甚至病毒一般传播,一起来看看吧


了解您的受众


首先,模因的选择一定要建立在受众的基础上。基于受众的年龄、文化背景、种族、位置、行业以及其他统计信息等,卖家可以为用户量身定制能够引起他们注意的模因。


发布原创模因


即使应用了流行的模因图片,您使用的信息也应该是原创的,并且在某种程度上与您的受众或品牌有关。


不管是提出要点还是唤起人们对美好时光的回忆,模因都要足够有趣才能引起受众的共鸣。


重复热门模因


模因的更新换代速度之快有目共睹,但有时候对过去的热门模因的采用也会有意想不到的效果,对已经流行的模因的即兴重复也是最容易创建的模因之一。


比如说,2018年的时候Ruffles巧妙地拍了一张几年前风靡一时的照片,也引起了不小的反响。


通过模因发展品牌个性


通过社交媒体账户,卖家可以增强当前的品牌个性或创建一个全新的品牌个性,卖家也要根据自己想要打造的形象对模因的风格进行筛选。


研究模因是否合适


在发布前卖家务必要仔细对模因进行检查,确保其内容没有冒犯性或其他问题,在敏感话题的发言也要更谨慎,毕竟一旦出错就可能会直接损害到自己的品牌形象。


保持模因的一致性


最后,卖家要注意的一点是,凡事不能一蹴而就,不管要发布什么样的模因,卖家都要始终保持一致,打造如一的品牌角色并坚持下来,否则可能会让受众产生疑惑。


原文转载:http://www.shaoqun.com/a/504676.html

跨境电商:https://www.ikjzd.com/

阿里巴巴 批发:https://www.ikjzd.com/w/1084

c2c模式:https://www.ikjzd.com/w/1576


各类网络流行语层出不穷,在社交平台上更是广泛传播,这也引起了各位卖家的关注,纷纷在社交媒体平台上用起了模因,也就是所谓的"梗",来蹭一波热度。虽然模因制作起来并不难,但应用模因也是需要一些计划的,数字化营销专家NeilPatel分享了一些小技巧,可以使您的模因具有可关联性,可共享性,甚至像病毒一般传播,一起来看看吧↓了解您的受众首先,模因的选择一定要建立在受众的基础上。基于受众的年龄、文化背景、种
一淘网比价平台:一淘网比价平台
ad公司:ad公司
eBay新动作,添加Google Pay作为新的付款选择:eBay新动作,添加Google Pay作为新的付款选择
亚马逊机器人发疯?亚马逊大批VC和SC账号被屠杀!竟是因为这封邮件……:亚马逊机器人发疯?亚马逊大批VC和SC账号被屠杀!竟是因为这封邮件……
山西太原特产;汾酒 - :山西太原特产;汾酒 -

速卖通公告:将延长部分发往俄罗斯订单时效

获悉,近日速卖通发布延长部分发往俄罗斯订单时效公告,原文如下:


受疫情影响东北地区多个陆运口岸(满洲里、绥芬河等)于11月初开始陆续执行交通管控,导致发往俄罗斯的部分订单在口岸积压,目前我们已通过其它运输方式在陆续运出中,为进一步减少对商家的影响,平台对美西时间2020.10.28日---2020.12.15日产生的发往俄罗斯,且使用【菜鸟特货专线-标准】及少量【无忧标准】线路的包裹


1. 原订单对应的买家收货时间(即限时达显示时间)从75天延长至90天。


2. 因不可抗力因素,原物流商承诺包裹自揽收或签收成功起60天内延长至90日,因物流商原因在90天内未妥投而引起的速卖通平台限时达纠纷赔款,由物流商承担赔偿责任。


物流相关纠纷同正常线上发货订单将进行免责。


受影响订单单号规则为:LQXXXXXXXXXCN


在过去的一年中,俄罗斯卖家在平台上的数量增长了7倍,到2020年10月达到22,000。平台上俄罗斯公司的商品范围达到350万件。本地卖家的销售额已占俄罗斯速卖通总营业额的20%。速卖通的包裹数量占俄罗斯邮政所有包裹的40%。


另外,全球速卖通针对中小企业推出了许多支持措施,开展了很多宣传活动,以支持时装品牌俄罗斯制造商和手工艺品企业。此外,速卖通向个体经营者敞开了大门,由于个体企业家人数的减少,个体经营者今年有所增加。


俄罗斯的速卖通卖家可以使用该国超过600个城市的超过18,000个菜鸟包裹码头。Tsainyao计划在2021年6月之前再投资10亿卢布,以加快整个俄罗斯的货物运送速度。


原文转载:http://www.shaoqun.com/a/504651.html

跨境电商:https://www.ikjzd.com/

易麦:https://www.ikjzd.com/w/2048

bol:https://www.ikjzd.com/w/291


获悉,近日速卖通发布延长部分发往俄罗斯订单时效公告,原文如下:受疫情影响东北地区多个陆运口岸(满洲里、绥芬河等)于11月初开始陆续执行交通管控,导致发往俄罗斯的部分订单在口岸积压,目前我们已通过其它运输方式在陆续运出中,为进一步减少对商家的影响,平台对美西时间2020.10.28日---2020.12.15日产生的发往俄罗斯,且使用【菜鸟特货专线-标准】及少量【无忧标准】线路的包裹。1.原订单对应
易佰:易佰
达方物流:达方物流
案例分享:亚马逊系统问题给卖家造成损失后的处理方式:案例分享:亚马逊系统问题给卖家造成损失后的处理方式
2020三亚凤凰岭春节好玩吗?三亚凤凰岭公园春节营业吗?:2020三亚凤凰岭春节好玩吗?三亚凤凰岭公园春节营业吗?
番禺国际美食节时间?广州沙湾古镇在哪里?:番禺国际美食节时间?广州沙湾古镇在哪里?

为什么 StackOverflow 上的代码片段会摧毁你的项目?

昨天公司里碰到一件令人哑然失笑的事情。帮朋友公司做的一个项目,做SIT测试的时候发现一些bug,仔细查了下原因,原来是因为当初觉得这个项目比较简单,交给了几个新入职的新丁,也算是给他们练练手,结果其中一位写了一段代码出现了问题结果导致bug的出现。

虽然问题不大很快就修复了,但是正所谓初生牛犊不怕虎,这位出问题的新丁不太服气,一直嚷嚷着他这段代码是从CSDN上找到的,别人都说好用他才用的。问了问他是否理解原文中那么写的原因,结果才支支吾吾了半天讲不清楚,最后也承认他只是看到那段代码的结果是他要的,并不是理解中间一些方法的运用到底是什么逻辑。

真是又好气又好笑,想想现在的年轻人真是有个性,自己当年遇到这种情况只敢虚心求教,哪敢都没明白就去用一段代码,别人指出问题还忿忿不平。

也许是自己老了吧。晚上和一个刚从国外归国的同学说起这个事情,他倒是深有体会,说到他们在国外留学时,遇到技术问题想到网上咨询用的最多的是StackOverflow,相比起国内的CSDN,他觉得StackOverflow上提问题的人和回答的人都更加严谨,不会有太多的废话和问题之外的讨论。按他的理解,CSDN上很多国内的技术新手纯粹是缺乏独立思考的能力,都只是来求代码完成目标,不去探究为什么这么写,本身CSDN上问题回答质量不高,这样很容易出事。

同学的看法,一方面可能是因为国内程序员需求极大,但整体浮躁、功利性的大环境导致很多培训机构没有培训到位,很多程序员都是一边开始工作一边学习;但另一方面,不排除他崇洋媚外的自满情绪。于是,我便去查阅了下StackOverflow上面的内容和相关资料。

仔细研究后发现,其实StackOverflow没有同学说的那么好,即使是该网站上的回答,也有很多有问题的代码。看来这还是一个世界性通用的难题~

对于国外的程序员来说,StackOverflow就是他们的CSDN,是他们遇到各种问题查询的第一选择,很多国外的程序员,会到StackOverflow上需求帮助,找到他们需要的解决问题的代码,然后不假思索的直接复制使用,和我公司出问题的那位年轻人一样,这个习惯很不好。

代码复制本身来说并不是什么坏事,我们学开发的时候,肯定老师都教过我们代码复用能有效提高软件的开发效率。已经被解决了的问题,实在没有必要再去重新写一遍代码。但是这个前提是,使用者,也就是开发人员,必须知道你要用的这段代码的来龙去脉真正含义,就是你要真正明白你用的代码。

简单举个例子:

  • 几年前,很多程序员发现,在windows上使用Docker老是会碰到无法启动的问题,原因一直不明,很多人都是重装了系统什么的才解决。后来有一个大神发文解释原因后我们才知道了为什么

当 Windows 后台启动了 Razer Synapse 时,再去启动 Docker 就会触发此问题。根本原因是,Razer Synapse 运行后,Docker 就会认为已经有一个 Docker 实例正在运行中,所以不会再启动一个实例,也就是真的Docker。

为什么会有这种情况呢?

因为有一段代码中,返回的 GUID 类型是 System.Reflection.RuntimeAssembly(系统层面的运行时程序集),而不是 Windows 中对应 Docker 程序集中定义的类型。Docker处理的逻辑就是在同一时间只允许运行一个实例,判断的方式就是通过判断 GUID 是否存在,但在获取GUID 时,用的是系统层面的而非自己独立程序集里面,从而导致了这个问题。问题代码如下:

var name = string.Format("Global\{0}", (object) Assembly.GetExecutingAssembly().GetType().GUID);

当然了,如果系统只有一个应用程序使用了上面的错误代码,那么这个问题还是不会出现,因为只有一个实例。但实际情况是很多应用程序都使用了这一段错误代码,结果就不允许两个实例同时运行。

那这些应用程序,想必你已经猜到,都用了这段代码,而且都是从StackOverflow上下载后不假思索的使用导致的。

  • Andreas Lundblad,国外一位大神,Palantir 的 Java 开发人员,同时也是 StackOverflow 上排名最高的贡献者之一。

他有一段代码,作用是将字节计数转换为更易于阅读的格式。打个比方,1024字节转换为1kB,1048576 字节转换为1MB。他最初在2010年将这一段代码放到了StackOverflow上,根据官方统计,他的这段代码是StackOverflow上被拷贝次数最多的Java代码,GitHub上使用这段代码的项目有6千多个。

当Andreas Lundblad知道此事后,出于负责,很小心谨慎的重新检查了下这段代码,随后发现这段代码里有一些问题,于是他马上更新了版本,并发博告诉大家:

  • StackOverflow 上的代码可能存在 bug,不管他的好评是多少。
  • 如果你拿了StackOverflow的代码,一定记住要测试所有的可能的情况。
  • 在复制代码时,一定要包括其来源和贡献者,当出问题时,能快速帮你定位。

同样的,在去年,国外另一位大神Morteza Verdi发表了一篇研究论文指出,StackOverflow上流传最广的一段c++代码存在着69个重大安全隐患漏洞,GitHub上使用这段C++代码的项目也有近3千多个。

所以,无论是StackOverflow还是CSDN,无论是国外和国内,都务必记住一点,在复用别人的代码时,一定要搞清楚别人代码的含义,并做好充分的测试工作,并不是说你运行了一次没问题,就是真的没问题,可能只是你运气好,没有触发问题场景罢了。

引用 Ryan Donovan 的一句话,就是:

If you borrow things and you don't understand the content of what you're borrowing, then you fall in this trap of reusing code that has potential vulnerabilities. Then you are just spreading those things around."

If you're going to reuse code, you need to understand that code.

复用代码,一定要理解代码!

  • 参考资料:https://medium.com/better-programming/why-code-snippets-from-stack-overflow-can-break-your-project-ced579a48ddb

你复用代码时遇到过什么问题?一起讨论下吧!

欢迎关注我的公众号:程序猿DD,获得独家整理的免费学习资源助力你的Java学习之路!另每周赠书不停哦~


原文转载:http://www.shaoqun.com/a/504645.html

跨境电商:https://www.ikjzd.com/

法瑞儿:https://www.ikjzd.com/w/412

一淘网比价平台:https://www.ikjzd.com/w/1698


昨天公司里碰到一件令人哑然失笑的事情。帮朋友公司做的一个项目,做SIT测试的时候发现一些bug,仔细查了下原因,原来是因为当初觉得这个项目比较简单,交给了几个新入职的新丁,也算是给他们练练手,结果其中一位写了一段代码出现了问题结果导致bug的出现。虽然问题不大很快就修复了,但是正所谓初生牛犊不怕虎,这位出问题的新丁不太服气,一直嚷嚷着他这段代码是从CSDN上找到的,别人都说好用他才用的。问了问他是
欧苏丹:欧苏丹
moss:moss
新西兰续缘霍比特人,史上最全指环王取景拍摄地旅游指南 :新西兰续缘霍比特人,史上最全指环王取景拍摄地旅游指南
深圳海洋奇梦馆什么时候开张?:深圳海洋奇梦馆什么时候开张?
【大连旅游】—大连特色店铺 - :【大连旅游】—大连特色店铺 -

线上杂货需求高!加拿大素食电商PlantX在多地开设货运中心

在疫情期间,网上购买食品杂货的需求在持续飙升。今年夏天,网上杂货店销售额创下了72亿美元的记录。很多网上杂货公司最近也有了新动作。


总部位于温哥华的素食食品电子商务网站PlantX最近宣布将业务扩展到美国和以色列,并开设了新的实体店作为货运中心。


PlantX于今年成立,一直在加拿大运营其电子商务网站,现在该服务正在扩展到向美国和以色列的消费者销售食品杂货。PlantX还将继续推进其在加州圣地亚哥和不列颠哥伦比亚省斯阔米什市开设其他实体店的计划,并计划未来在北美各地开设连锁商店。


PlantX目前在美国开设的第一家店位于圣迭戈,它将提供5000种产品,包括自有品牌商品,如PlantX水,以及有机物维生素补充剂,方形巧克力棒和其他广受欢迎的素食品牌。


这家位于圣地亚哥的商店还将提供素食教育中心、咖啡店等。此外,为了鼓励人们继续使用其电子商务网站,PlantX的客户也可以在这些实体店的自助器上购物,用手机扫描二维码,让食品杂货送到他们家里。


该公司拥有域名www.PlantX.co.il,并将在旗舰店和实体店推出该域名。PlantX在其他地方扩张的实体店,如以色列商铺将获得与北美客户同样的在线体验和服务,包括素食餐食配送、获取素食产品、每周更新的食谱、素食餐厅定位器和关于素食饮食文化趋势的文章资讯。


PlantX副总裁Blicher表示,由于现代人越来越追求绿色健康的饮食习惯,北美人现在总体对素食产品有很强的倾向以及线上购物的流行,PlantX公司的愿景是在每个国家都有实体店,让全世界的消费者都能使用该电子商务网站。除了在每个国家的主要旗舰店外,PlantX还将在未来开设一些小型体验店,作为实践中心和学习中心。


原文转载:http://www.shaoqun.com/a/504635.html

跨境电商:https://www.ikjzd.com/

heap:https://www.ikjzd.com/w/2012

outfit:https://www.ikjzd.com/w/938


在疫情期间,网上购买食品杂货的需求在持续飙升。今年夏天,网上杂货店销售额创下了72亿美元的记录。很多网上杂货公司最近也有了新动作。总部位于温哥华的素食食品电子商务网站PlantX最近宣布将业务扩展到美国和以色列,并开设了新的实体店作为货运中心。PlantX于今年成立,一直在加拿大运营其电子商务网站,现在该服务正在扩展到向美国和以色列的消费者销售食品杂货。PlantX还将继续推进其在加州圣地亚哥和不
1淘网:1淘网
dmm杂志:dmm杂志
(精品分析)亚马逊美国站杂货袋类目市场调查数据报告:(精品分析)亚马逊美国站杂货袋类目市场调查数据报告
速卖通爆款如何打造?到底有哪些技巧?:速卖通爆款如何打造?到底有哪些技巧?
怀集燕岩简介?广东怀集燕岩怎么样?:怀集燕岩简介?广东怀集燕岩怎么样?

2020年跨境电商大事件盘点

2020年跨境电商大事件盘点

又到了岁末年初,2020年疫情导致大部分行业,都受到了不同程度的冲击。跨境行业在这一年也经历了一波三折,当然,是苦是甜,也只有身在其中的跨境卖家,工厂和各类服务商才能体会到。今天就带大家一起来回顾下过去12个月,发生在跨境人身边的种种经历。

1月,英国正式脱欧

当地时间1月31日23点,也就是北京时间早上7点钟,英国正式脱离欧盟,这一决定给跨境电商大环境也带来了许多不确定因素。

据悉,英国将于2021年1月1日正式推出欧盟单一市场和海关联盟。届时,英国和欧盟之间将增设海关边境,这将对英国和欧盟之间的跨境业务产生影响。增值税号以及EORI号,包括品牌商标也都需要做提前的布局更换。

2月,亚马逊上调配送费及多项服务费用变更

自2020年2月8日起,物流费和销售佣金有所变化。其中,配送费用进行约 3% 的小幅上调。这些变更将于 2020 年 2 月 18 日生效。弃置,移除等服务费用也都做了相应变更,整体呈上升趋势。

3月,国外疫情加剧,FBA非必要商品停止入库

受到疫情的影响,FBA优先在运营中心接受生活必需品和医疗用品。非生活必需品(household staples)或医疗用品(medical supplies)类商品不能发往亚马逊运营中心。此入库限制3月17日起,执行至4月5日,适用于美国和欧盟市场。

此举动引起了行业内的巨大震荡,大部分欧美卖家开始进驻其他站点,其中日本站占据了大部分,至此,亚马逊日本站竞争开始加剧。

4月,室内家居类产品海外需求增长爆发。

受到疫情影响,原本以实体店为主要营销模式的欧美家居行业,受到了严重冲击,不少门店被迫停业。然而,市场需求仍然存在,海外消费者将目光转向了线上购物,得益于此,亚马逊欧美家居市场大卖家致欧网络,销量大涨,并拟在A股上市。

5月,被亚马逊封杀的中国口罩卖家:有人千万资金被冻结,申诉遥遥

60多位亚马逊中国卖家,来到深圳市南山区来福士广场大厦聚集,这里是亚马逊的深圳办公室所在地。他们身穿白色T恤,上面写着 "亚马逊还我血汗钱"。据了解,政府有关部门出面进行了调解,亚马逊方招商经理约定第二天进行沟通。但是到了晚上这些卖家接到消息,"亚马逊深圳办事处次日停止办公",维权的卖家们陷入了进退两难的境地。

疫情让医疗物资变为香饽饽,但同时平台监管的收紧,也导致了部分卖家喜忧参半,资金链拉长,风险增大。

6月,日本海关关税逆算加剧

不少卖家爆料日本海关换届,开始严查低申报,卖家面临巨额关税,许多卖家甚至表示税费被运费还高,交完关税利润直接为负。之前7天就能过海关,现在1个月了一直没有过海关。而且先要排仓,现在海关又严查,时效得不到保障。有卖家反映:日本对中国卖家FBA货物关税申报高达售价的35%,更有离谱的甚至高达55%。

日本商品低申报时代一去不复返,但是众多卖家一视同仁,或许在同样的严厉监管下,对中小卖家是一次突围的机会。

7月,海外出行类目销售暴涨

意大利、英国、西班牙等欧洲国家慢慢从第一次"禁足令"中"解封",民众渴望出门,又害怕公共交通成为感染地,所以环保、轻巧的自行车就自然而然受到青睐。与此同时,自行车在欧洲走俏,意大利、英国、法国的销售量分别暴涨9倍、8倍和4倍。就在自行车和电动滑板车销量蹭蹭蹭上涨时,意大利政府也出台购车补贴,市民购买自行车和电动滑板车可先行垫资,凭购买凭证随后向政府申请补贴。

自行车出口迎来红利时刻,众多国内自行车生产工厂全年订单已经饱和,同时自行车相关供应链也搭上顺风车,进入高速发展赛道

8月,亚马逊限制发货

从 2020 年 8 月 16 日至今年年底,分数低于500 的卖家将会有仓储限制。

库存绩效分数从最初的350分,提高到前段时间的400分,再提高到500分,一方面表明官方在为下半年旺季做提前规划,减少因疫情原因导致的人手不够,而产生的爆仓;另一方面也说明了平台在筛选优质卖家,进行选择性的资源倾斜。

9月,跨境行业迎来资本追逐


2020年9月跨境电商领域共有5家平台获得融资,分别是欧税通、行云集团、斯达领科、美刻生活、KKS,融资总额超17.1亿人民币。

跨境电商进入了资本追逐的时代,线下渠道因为疫情原因的冲击,需求在线上得以释放;同时国外疫情的蔓延,更加依赖于中国制造。

10月,亚马逊会员日姗姗来迟

今年的Prime Day因疫情影响而推迟到了10月份。在Prime Day期间,第三方卖家在Amazon上的销售额超过35亿美元,比去增长了60%。根据部分客户数据,品牌商的销售额同比增长近600%。其中,广告每次点击费用(CPC)同比有大幅增长。

全球最畅销的产品仍然是亚马逊自己的产品:支持Alexa的Echo Dot和FireStick 4K。其他畅销产品包括iRobot Roomba机器人吸尘器,LifeStraw个人滤水器和LEGO星球大战突击队头盔。

11月,集装箱紧缺,一柜难求

11月份,中国出口增速达到了21.1%,贸易顺差创下40年以来的最高值!年初因为疫情封锁、工人、原材料紧缺,还一片萧条的中国制造业,到了2020年年底,全世界都在期盼着中国的货运。

因为国外的订单暴涨,集装箱正变得一柜难求!在海外物流、外贸人的朋友圈,最近谈论最多的话题就是:哪里有箱子啊?带带我们家货呗……价格怎么这么高啊,比之前的价格贵了不止三四倍。

12月,江浙地区工厂限电,生产影响

回溯过去两周,"南方三省限电"一度冲上热搜话题榜。在工厂密集的浙江义乌,不少企业加班加点生产,生产线满负荷甚至超负荷运转,用电量短时期出现暴增。再叠加冬季取暖用电的影响,用电载荷量几乎达到极值。

几乎是所有制造企业都受到一定程度的影响,江浙地区作为国内乃至全球重要的纺织生产基地,在年末的纺织生产中发挥着极其重要的作用。但浙江地区此次的限电停产必然导致大量纺织订单无处生产或者生产交期延误,同时也就意味着这类订单有着强烈的转移意愿。

2020即将成为过往,当然以上也仅仅是行业新闻里的一小部分,还有更多的事件就不再一一赘述。总结过去一年的成败得失,迎接崭新的到来,2021将会继续精彩。


来源:跨境小人物

文章来源:https://www.ikjzd.com/home/139045

跨境电商:https://www.ikjzd.com/

海拍客:https://www.ikjzd.com/w/1742

海维:https://www.ikjzd.com/w/1891

一淘网比价平台:https://www.ikjzd.com/w/1698

2020年跨境电商大事件盘点

又到了岁末年初,2020年疫情导致大部分行业,都受到了不同程度的冲击。跨境行业在这一年也经历了一波三折,当然,是苦是甜,也只有身在其中的跨境卖家,工厂和各类服务商才能体会到。今天就带大家一起来回顾下过去12个月,发生在跨境人身边的种种经历。1月,英国正式脱欧当地时间1月31日23

已失控!美线运价突然飙涨近10%,现货运价的强势已波及明年合同运价

已失控!美线运价突然飙涨近10%,现货运价的强势已波及明年合同运价

美线运价突然飙涨近10%!

怕来的还是来了,美线运价一夜之间飙涨近10%。这可能只是开始,离1月分运价继续上涨还会远吗?

已失控!美线运价突然飙涨近10%,现货运价的强势已波及明年合同运价

亚美跨太平洋航线集装箱需求自9月中旬以来一直在波动且愈发强劲,但亚洲到美西的集装箱运价自9月底以来一直出奇平稳,基本保持在3800美元至3900美元/FEU相对高位窄幅区间浮动。在需求波动巨大的最近几个月,运价趋势曲线的平稳导致人们遐想,跨太平洋地区的运价水平实际上是不自然的。而同期中欧的运价则增长了67%。

据波罗的海每日运价指数(Freightos Baltic Daily Index)(全球集装箱货运指数)显示,28日,亚洲-美西海岸运费创下历史新高,达到4189美元/FEU(30日显示运价已达到4200美元),时隔两天后较上周五突然增加8%。该航线目前运价几乎是去年同期的三倍。

亚洲到美东航线的运价也在上涨。28日的数据显示,即期运价为每FEU5397美元(30日显示运价已达到5405美元),较上周五上涨9%。该航线目前运价是去年同期的两倍。

但值得深思的是,这个运价是真实运价吗?有业内人士表示,即期运价的平稳状态实际上是一种幻觉。你看到的价格是非溢价服务支付的价格,但如今以这个运价发货已经不多了。你实际上需要在这个价格的基础上支付一大笔额外费用。一些运营商(每FEU)收取1500美元甚至2000美元的额外费用,只是为了保证设备和舱位。如果连舱位和设备都没有,那么3800美元或4000美元的价格又有什么意义呢?实际上,你需要支付5000美元或6000美元(每FEU)才能获得舱位。否则你得等上三四个星期。

Freightos的研究主管Judah Levine表示:"海运需求仍在飙升,由此引发的全球设备短缺,推动了本周大部分主要的亚洲航线的运价上涨,而需求上涨压力似乎有所放缓。" Judah Levine推测:"最令人惊讶的是,本次运价突然跳涨,是这两条跨太平洋航线的运价自9月中旬以来首次大幅攀升,这可能表明航运公司与相关监管机构达成的不提高这些航线运价的默契可能即将结束。"

1月1日起船公司上调附加费

12月底运价突然跳涨似乎为一月份的持续超高运价奠定了基础,目前仍看不到涨停的迹象。根据船公司发布的通知,继12月中旬增加附加费后,一些航运公司计划从周五及1月1日起开始实施一般费率上调(GRI)。

1月1日,CMA CGM,中远(仅适用于服务合同),Evergreen,HMM,ONE,Yang Ming和ZIM宣布了每FEU 1,000美元的亚美GRI。此外,赫伯罗特在1月1日列出的每个FEU GRI的价格为1,500美元,其中包括先前推迟的GRI。

服务于东亚/美国贸易航线(美国进口)的多家承运人已经调整了燃油附加费,自2021年1月1日至3月31日生效。这是承运人在FMC关税中公布的附加费:

为了应对将货物运到美国内陆地区的卡车和/或铁路成本的持续增长,跨太平洋东行贸易的主要承运人继续征收东亚/美国贸易航线(美国进口)的内陆附加费。

与此同时,南加州港口一如既往地繁忙。南加州海事交易所(Marine Exchange of Southern California)周一报告称,有24艘集装箱船停泊在圣佩德罗湾。另有5艘即将抵达,4艘将离开安克雷奇前往洛杉矶港口或长滩。海洋交易所报告说,锚地已满,几个应急锚地也已占用。最近几周,局势没有好转似乎恶化了。

洛杉矶港官方提供的数据显示,最近几个月,拥堵持续给该港带来了大量的货物流量。截至周二,该港口预计在当前假日周进口116501个20英尺标准箱(teu)。1月上旬的舱单数据显示,货运量大幅增加,达到每周15万标准箱。

综合以上港口数据、停泊船只、拟议的GRI时间表来看,美线本次运价上涨只是开始,离1月分运价继续上涨还会远吗?

再来看看欧地线运价走势

近期英国发现变异病毒致欧洲各国管控升级,此外英国脱欧时限邻近导致港口业务繁忙,再加上年末又值圣诞季,欧洲市场货量处于高位,也加剧了欧洲港口拥堵,导致集装箱周转不畅,供需矛盾加剧。受此影响,船公司继续提涨运价,欧洲航线即期市场价格在25日出现大幅攀升。地中海航线,市场情况与欧洲基本相似,即期市场运价在15日出现大涨后维持平稳。

现货运价的强势已波及明年合同运价

得益于船公司严格的运力控制,集装箱航运业实现了多年来的最高利润。2021年,集装箱航运业面临的最大问题不是能否保持较高现货运价,而是这种优势是否会影响到合同运价。

已经有迹象显示合同运价在上涨,据Sea-Intelligence一份评估报告显示,自9月以来,持续较高的现货运价正在转化为合同运价。"就2021年而言,总体合同运价水平确实可能大大高于近年来的水平,因此,无论新冠是否得到控制,2020年的疫情将对2021年合同产生强烈的连锁反应。"Sea-Intelligence在分析中表示。

正在参加跨太平洋运输服务谈判的美国进口商表示,他们的重点是确保运力和确保服务可靠性,而不是抵制价格上涨。11月,ZIM总裁兼首席执行官Eli Glickman表示,运费"将比去年高得多,这是目前的趋势"。"现在,运价不是问题;舱位是问题所在。为了获得舱位,客户愿意付出任何代价。"

但也有不同观点,更高的现货运价并不保证更高的合同运价。SCFI的数据显示,11月底,从亚洲到欧洲的单个TEU运费达到了10年来的最高水平。赫伯罗特首席执行官Rolf Habben Jansen认为,飙升的亚欧现货运价并不能真实反映整个市场,因为这些交易中超过一半的集装箱是以价格低得多的合同运价运输的。

尽管如此,更高的现货运价对航运公司今年的利润贡献很大。Drewry在10月份将其对2020年集装箱运输运营利润的预期上调了16%,达到110亿美元,这是十年未见的水平。根据sea intelligence的数据,11家船公司公开发布收益报告显示在第三季度的息税前利润(EBIT)均为正,其中9家公司的收入同比大幅增长。

令航运公司感到鼓舞的是,2021年集装箱运量增长的前景强于计划的运力扩张。GTA Forecasting预计2021年全球集装箱运量将比2020年增长5.8%。然而,集装箱运力只会增长2%到3%。

GTA forecast在其最新的《世界经济和贸易趋势》报告中表示:"展望未来,我们预计全球复合增长率(CAGR)在中期(2021-25年)将达到4.1%,在长期(2021-30年)将达到3.4%。"

多年来,集装箱运输公司一直在减少总运力方面的新船订单,使其摆脱导致降价的运力过剩的局面。然而,订单萎缩、跨太平洋和亚欧贸易创纪录的现货运价、以及强劲的总体利润和船舶准班率大幅下降,令托运人和货运公司都感到不满。根据sea intelligence的数据,全球范围内,船舶准班率在10月份达到了52.4%的历史新低。这比9月下降3.6个百分点,比2019年10月下降26.7个百分点。10月份,所有行业的船舶平均延误时间为4.86天,高于上年同期的4.11天。

航运公司指出,西方经济体对亚洲进口需求的意外波动、港口拥堵以及太平洋和大西洋的风暴,对他们的航行运输构成了挑战。与此同时,航运公司推出了优质的跨太平洋服务,提供有保障的装载、快速运输、快速卸货和专用的航行服务。这反映出集装箱运输已从商品化向更高水平的服务迈进了一步,但这已被承运商努力履行其优质承诺所破坏。

随着托运人不满情绪的加剧,监管机构加大了对集装箱承运人的警告力度,并对其进行了监控。由于市场波动,美国联邦海事委员会(FMC)在11月下旬告诉三大航运联盟,它们需要按月而不是按季度提供特定承运人的贸易数据。

此外,该机构还在调查航运公司在洛杉矶、长滩、纽约和新泽西港口拥堵中扮演的角色。FMC在其补充命令中指出,一些集装箱航线拒绝运输美国出口货物,导致美国两大集装箱港口的拥堵,同时还存在滞期滞留做法以及码头空集装箱退运的问题。

亚洲的监管机构甚至更为激进。韩国当局在11月12日约谈了9家船公司,要求其降低飞涨的运价格并改善服务以解决运力短缺的问题,而中国监管机构在9月11日强烈建议航空公司增加运力,避免大幅加价。

如果承运人的盈利能力和服务在2021年进一步扩大,集装箱航运公司将面临更多监管机构的严格审查和更严厉的制裁行为。


来源:海运网


文章来源:https://www.ikjzd.com/home/139074

跨境电商:https://www.ikjzd.com/

stadium:https://www.ikjzd.com/w/2729

pocket:https://www.ikjzd.com/w/1903

声网:https://www.ikjzd.com/w/2176

已失控!美线运价突然飙涨近10%,现货运价的强势已波及明年合同运价

怕来的还是来了,美线运价一夜之间飙涨近10%。该航线目前运价是去年同期的两倍。现货运价的强势已波及明年合同运价得益于船公司严格的运力控制,集装箱航运业实现了多年来的最高利润。已经有迹象显示合同运价在上涨,据Sea-Intelligence一份评估报告显示,自9月以来,持续较高的现货运价正在转化为合同运价。

国际站电商应如何进行选品?

国际站电商应如何进行选品?

今天来聊一个话题,选品。原本想解读一下搜索,既然有小伙伴提出这个话题,那就聊一聊选品。

想做好一个店铺,七分靠选品,三分靠运营。这个说法真的是毫不夸张,遇到好的店铺,好的产品,真的是不需要怎么操作就可以做起来。理由也很简单,这里涉及一些SEO的原理,总之,卖的越好的产品,自身效果的迭代会让其良性循环。

关于选品的重要性,是很多运营都比较认可的。但是它却不是每一个运营都应该做的。

选品这件事对于运营的职位和权利,有着必然的关系。对于有些公司,有些工厂来说。本身就是生产这个产品的,运营只需要把它卖出去即可。不需要运营去选一些产品来销售。这时候运营要做的,应该是测品,选出效果相对优质的去布局操作,当然,有些类目连这样选择的权利也没有。

选品,对于一些纯商业导向(只想卖货赚钱,不想注入情怀)的贸易公司和初创公司更加适合。在茫茫大海中,没有任何约束的去调研和选择高利润的快销品。其次,是想基于现有类目进行相关拓展的公司比较适用。来完善自己的产品线获取更多的流量。

选品的目的很简单,要么是从茫茫大海中选择想要切入的类目,做某一个系列的产品,要么是从一些产品中,选择出我要操作的具体产品。或者是从茫茫大海中,直接选择产品。总之,最终都是以挑出产品为结果。

(常见的还有市场数据调研选款,工具选款,资讯选款等)

其实不论哪种方式,我们都希望选出的产品易操作,能赚钱。最好是产品发上去什么都不做,这个产品就能卖。这对于市场环境和买家需求有着极高的要求。大量的买家都有着需求,而竞争很小,那么你自然就很轻松。

就好比学校的食堂,如果只有一家早餐店,口味极好,价格公道,那么它运营起来肯定会很轻松。甚至它都不需要去做广告,每天都会有很长的队伍在门口。

假设这个学校食堂的早餐店越来越多,那么你的流量就会被瓜分,这个时候,如果你的早餐依旧很好,味美价廉,我相信还是有机会做的不错。或者你切入的比较早,大家已经熟知了你,我相信也是有机会做的很轻松的。

如果你别出心裁,准备卖精致的高价早点。在深入了解这群学生群体的情况下,对商品进行包装,也是可以做起来的。因为人群基数大,你只要拿到一点点的份额。整体利润也会不错,因为单价的利润就已经很高。相对轻松且高档。  

但是,如果你非要卖一些极少数人才会吃的早点,或者是大家都不习惯的早餐。即便你投入再多的广告或者找再多的人去假装排队。也很难盈利,因为大家从心底就不会选择这类产品。市场需求量几乎为0,最终容易自欺欺人。

而还原到电商场景中,这些就是热度,竞争度,需求量,产品、价值和目标群体的研究。选择一个产品,就要了解市场,了解竞争环境,了解买家人群。

关于市场现状

一个产品,或者一个关键词的热度高。这是千千万万买家在搜索框里搜索行为的数据体现。所以选品来说,我们一般会参考热度、以及竞争度。

热度高,反映的是买家需求量大不大。竞争度反映的是卖的人多不多。热度竞争比则初步体现了操作上的难易程度。

当我们切入一个品类时,需要对产品所在市场情况进行深入的挖掘,比如我们选择了服饰这个行业,准备做连衣裙这个产品,产品本身有很多的子类目或者子属性。

比如,研究连衣裙在服饰类目下的份额占比,以及它在同类产品中的数据占比。反映着买家在整个子市场下的分布情况。同时也可以给我们后续产品线的拓展提供着决策数据。

(通过热度、金额或人数对比来观察不同类目或不同属性的市场需求分布)

此外,如果想深入挖掘,还可以细分所选产品的属性。拿服饰来说,或者裙子来说,我就发现"麻"这个材质的商品在商场近些年就有升高的趋势。

我们可以在数据管家中很容易的整理出产品各个细分属性的市场容量占比以及趋势。这个容量及趋势可以帮助我们判断市场的现状分布以及未来可能发生的趋势走向。

最后,除了细分属性的容量及趋势分布,产品自身也有着整体的趋势与规律。我们可以参照近几年的数据,去判断这个产品的走势和规律。是常规性产品,还是季节性产品,亦或是节日性产品。他们在数据表现中,都有着规律的峰值起伏。同时,它也是我们运营节奏或者是市场切入的时间提示。

(把不同的属性,堆叠在一起,观察近五年的分布及变化情况)

关于市场潜力

它和前面的市场现状,几乎是同一回事,除了用热度来衡量市场容量,也可以是销售额或者销售量。只是对于批发类平台来说,热度是相对最准确的。

甚至我们也可以评估TOP的数据来判断市场的容量。只是看top的同时,还需要看一下top前20或30的分布情况,基于此来看市场的垄断情况。如果效果全都集中在前几名,而且效果层次差距很大,这很可能是垄断性很强的行业。如果此行业已经有了很成熟的大卖家,进入时就要结合自己的情况,慎重考虑。

(现有竞争环境分析)

我们评估市场潜力,除了市场容量外,还需要看一些具体的目标对手的数据表现,比如,搜索结果的产品重复率,如果重复率太高,竞争商家太多,切入的时候就要根据自己的资源来做一个粗略的计划,能竞争的过谁,能做到哪个位置,或者是选择放弃。

这些商家的现状如何,上架时间是多少,评价数量有多少,产品实力怎样。有一个大致的了解。观察类似产品及店铺的效果,排名。它们的价值特征和属性。来不断的修正我们所能达到的预期位置。

让我们把眼光放长远一点,基于大的时代背景下。此产品所处的市场趋势如何?是上升阶段,还是下滑阶段,它所处的市场是增长的,还是稳定的。我们可以通过观察国贸政策、全球消费环境等,甚至可以借助于谷歌工具或海关数据,来看更加具体的数据趋势。

(数据来源:谷歌趋势)

如果这些你觉得困难,也可以观察一些网站的销量变化,国内外平台都可以。最近哪些商品在飙升,哪些产品在下降。选一个周期,来看市场的微妙变化。

关于产品

我们在选择产品的时候,必须要了解预选产品的特性。它是季节性产品还是全年性产品,它处于高热度的红海还是中热度的蓝海。它是类似于指尖陀螺一样的暂时性的产品还是像原材料一样的几年都不会更新淘汰的产品。它是像牙膏一样的高复购的消耗性产品,还是长期使用的一去不复返的产品。

这个特性很多,不同的行业有着不同的要求。没有必要完全一致的去套用,总之,当你选择一个预期产品的时候,去深入了解这个产品的特性是绝对没有坏处的。

当我们框定了预期产品之后,我们还需要考虑后续的操作。去审视它本身的短板。这个产品的品质是不是足够硬,它的包装是不是足够让它显得精致。它是不是容易使用,不会产生大量的售后问题。它的价值是否满足你的定位或者你的推广文案等等。还有店铺后期拓展品类的时候,是否方便根据这类产品去拓展其他相近的品类,来完善你的店铺产品布局。

说到产品,我更想强调一下价值。一个产品销售的好不好,很大程度上取决于它是否能依靠自身的特定属性来满足特定受众的特定需求。

它要求我们对产品,对目标人群有着极高的关注与兴趣。需要对消费者的生活环境以及本土化的生活习性有着深入的了解。它是一部需求与文明的进化论。如果你不知道从哪里入手,不妨去看一看买家的评价,问题或是相关资讯,会是一件很有意思的事情。

(整体的市场呈现,是无数条细分曲线微妙变化的结果)

当我们确定了预期款之后,必须考虑的维度还有价格。市场上的售价是多少,你的预期售价是多少,选品,一定要权衡利润与单量的关系,是需要跑量还是高利润型,影响着后期的操作手法。

同时,利润空间也决定着后期的操作力度, 各种运营方式也都需要费用。我们可以研究市场价格及对应的销量分布,结合自身的成本情况,进行一个合理的定价。

除了成本与利润的计算,还需要调研计算一些推广成本和运营成本,其中也都涉及着一些影响产品操作难度的重要指标。不同的行业,不同的产品,有着各自不同的研究要点。

作为运营,除了要会研究数据,对消费者的心理和行为,乃至他们的生活环境都要有着深厚的了解。研究行为,现象,与研究数据一样重要。

最后,也是最重要的一点,就是当我们选好了产品之后,对产品自身的研究,如何将其销售出去,如何拟定卖点,如何定位,可以参考聊视觉的那些文章。对产品的深入了解,是营销成功的前提。定位有多透彻,后续操作就有多简单。

写到这里,基本上是结束了,信息量还是多少有些大的。分享的比较粗糙,很多细节和实操的部分没有详细展开,每个点展开写,怕是要唠唠叨叨没完没了了。

选品实际上并没有中规中矩的方法,不同行业,不同的选品对象,所考虑的内容和重点也是有差异的。但是有一点是相通的,大道至简,不论是哪种平台,线上还是线下。那就是这个品有它的特性受众,有它的特定价值。有着足够的需求量,买的人越多,卖的人越少。那这个品就越容易产生交易。


(来源:5颜6色的世界)

文章来源:https://www.ikjzd.com/home/138995

跨境电商:https://www.ikjzd.com/

picitup:https://www.ikjzd.com/w/446

美菜:https://www.ikjzd.com/w/1874

photobucket:https://www.ikjzd.com/w/132

国际站电商应如何进行选品?

想做好一个店铺,七分靠选品,三分靠运营。这个说法真的是毫不夸张,遇到好的店铺,好的产品,真的是不需要怎么操作就可以做起来。理由也很简单,这里涉及一些SEO的原理,总之,卖的越好的产品,自身效果的迭代会让其良性循环。

C# 9 新特性——init only setter

c# 9 init only setter

C# 9 新特性——init only setter

Intro

C# 9 中新支持了 init 关键字,这是一个特殊的 setter,用来指定只能在对象初始化的时候进行赋值,另外支持构造器简化的写法,比如:Target-typed new expression 在已知类型的情况下可以使用 new() 来代表构造方法的简化用法,可以简化字段的声明,也可以简化一次声明多个相同类型的变量

Sample

来看一个示例,我们定义一个测试用的 Person 类,测试代码如下:

public class Person{ public int Age { get; init; } public string Name { get; init; } public string Description { get; set; } public override string ToString() {  return $"Name:{Name}(Age:{Age})"; }}

init 是一个特殊的 setter 适用于实例属性,被标记为 init 的属性,只能在实例化的时候通过初始化器来赋值,实例化操作完成后不允许再修改值。

var p1 = new Person(){ Name = "Michael", Age = 10};Console.WriteLine(p1);// compiler error,不能对 init 的字段再赋值// p1.Age = 12;// Target-Typed new expression, C#9 新特性Person p2 = new(){ Name = "Jane", Age = 10,}, p3 = new(){ Name = "Alice"};Console.WriteLine(p2);Console.WriteLine(p3);

init 的等效写法,init 类似于 set ,但是 init 对应的字段会是一个 readonly 的字段,来保证只能在构造器中或者初始化器中被赋值,另外编译器会做检查如果是 init,会有一个特殊的标识,在初始化后再赋值的时候就会报错,类似于下面这样:

internal class TestInitModel{ private readonly string _name; public string Name {  get => _name;  init => _name = value; }}

我们以上面的 Person 为例来看一下生成 IL 代码的区别:

可以看到声明为 init 的 属性会比普通的 set 多出来一个修饰符,这是由编译器去生成的,编译器也会根据此去判断是否是在初始化的时候赋值,如果不是就会报错。

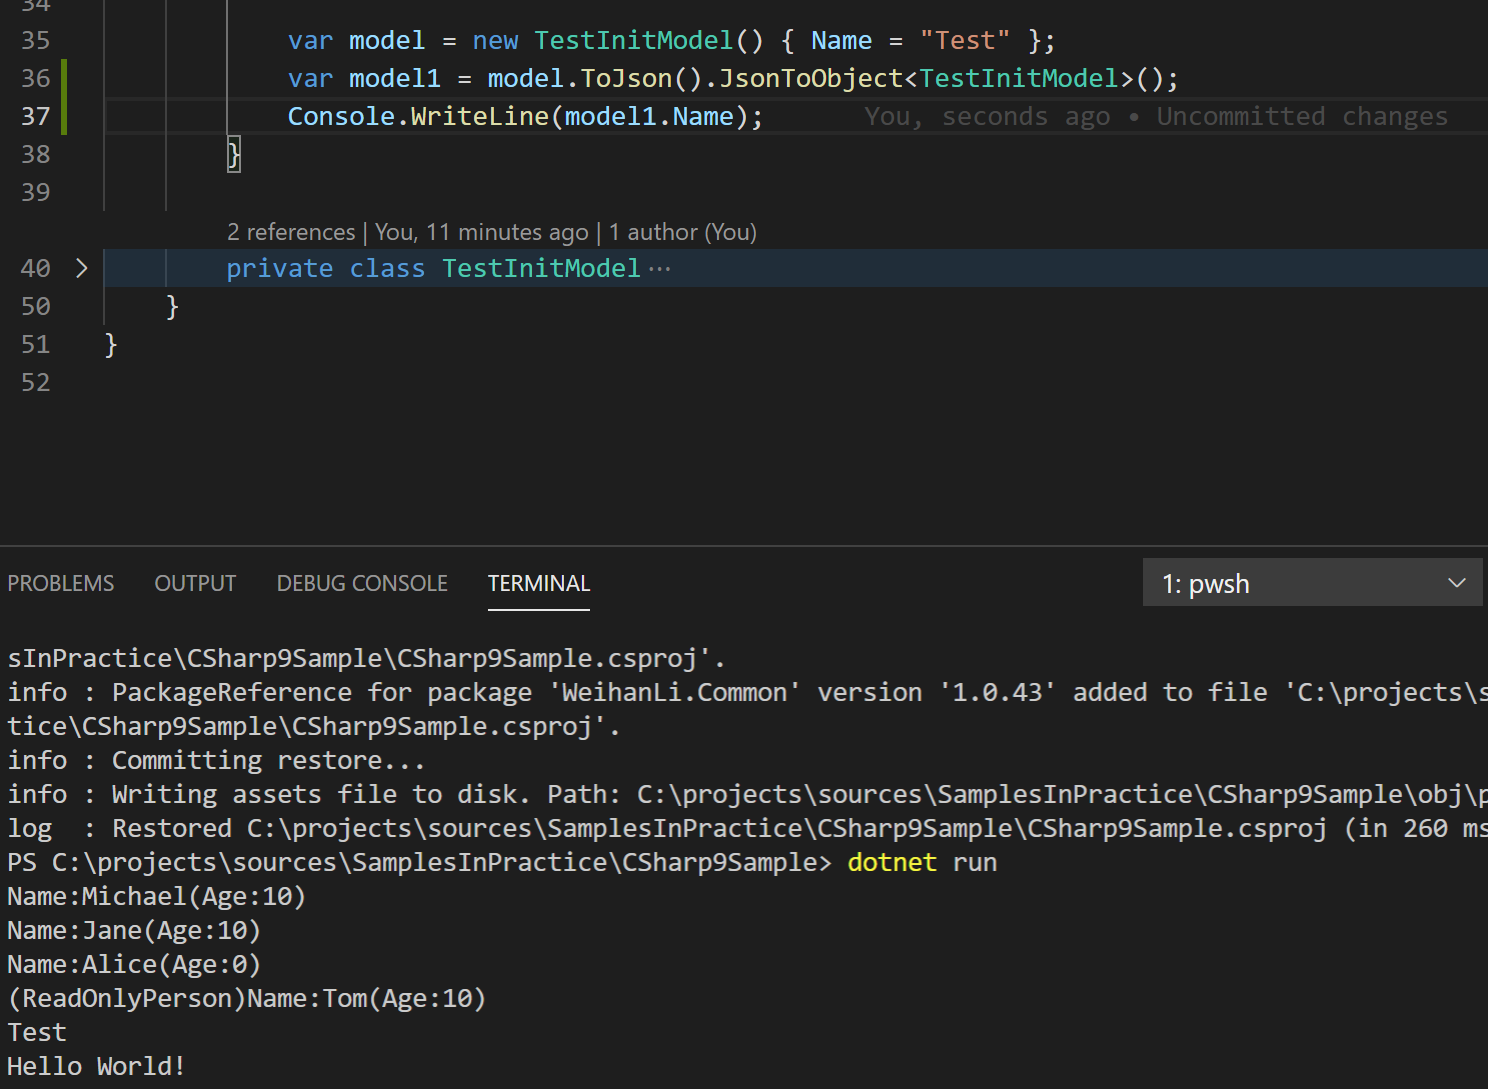
序列化是否会有问题呢,我们来测试一下,可以看到 model1 是被正常赋值(这里的 ToJson/JsonToObject是基于 Newtonsoft.JsonJsonConvert 封装的扩展方法)

More

我觉得 init 为我们带来的好处在于,可以在初始化的时候赋值而非直接通过构造器赋值,如果希望一个属性只能 get ,不在初始化之外的地方被赋值,之前我的做法都是在构造器里初始化,只保留一个 getter,没有 setter,有了这个支持之后就可以不需要修改构造方法比较方便的使用了

Reference

  • https://docs.microsoft.com/en-us/dotnet/csharp/whats-new/csharp-9
  • https://github.com/WeihanLi/SamplesInPractice/tree/master/CSharp9Sample
  • https://github.com/WeihanLi/SamplesInPractice/blob/master/CSharp9Sample/InitOnlySample.cs


原文转载:http://www.shaoqun.com/a/504562.html

跨境电商:https://www.ikjzd.com/

heap:https://www.ikjzd.com/w/2012

蜜芽宝贝:https://www.ikjzd.com/w/1320


c#9initonlysetterC#9新特性——initonlysetterIntroC#9中新支持了init关键字,这是一个特殊的setter,用来指定只能在对象初始化的时候进行赋值,另外支持构造器简化的写法,比如:Target-typednewexpression在已知类型的情况下可以使用new()来代表构造方法的简化用法,可以简化字段的声明,也可以简化一次声明多个相同类型的变量Sample
泛亚班拿:泛亚班拿
inkfrog:inkfrog
去哪个海岛度蜜月最好?:去哪个海岛度蜜月最好?
嘉兴凤桥4A级旅游景区和3个3A级景区村庄实力"圈粉":嘉兴凤桥4A级旅游景区和3个3A级景区村庄实力"圈粉"
亚布力购物信息 :亚布力购物信息

Log4j日志框架

日志框架Log4j的使用介绍。

简介

  • 本篇是关于Log4j日志框架的介绍。
  • 阅读本文请至少了解JUL日志框架,因为大部分的知识点是类似的。

Log4j日志框架

  • Log4j全称是Log for Java,它是Apache的一个开源项目,通过使用Log4j,我们可以控制日志信息输出的位置是控制台、文件还是GUI组件,输出位置甚至可以是套接口服务器、NT的事件记录器、UNIX Syslog守护进程等;
  • 使用Log4j也可以控制每一条日志的输出格式;通过定义每一条日志信息的级别,我们能够更加细致地控制日志的生成过程。

入门案例

  • 所使用的项目使用Maven构建,需要引入Log4j依赖:
<dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> <version>1.2.17</version></dependency>
  • Log4j默认情况下是需要提供配置文件的,如果resource目录下不存在log4j.properties配置文件,则控制台中会输出相应的警告信息。
  • 考虑以下代码:
@Testpublic void test() { // 1.在没有log4j.properties的情况下,获取日志记录器对象Logger Logger logger = Logger.getLogger(Log4jTest.class); // 2.尝试输出日志记录 logger.info("Hey, log4j.");}
  • 此时控制台输出为:

  • 接触过JUL的都知道,当普通的Logger没有进行额外的配置时,其默认会继承并使用RootLogger的配置。
  • 同样地,Log4j中也存在RootLogger,但由于默认情况下RootLogger不具有任何的Appender(即Handler)。
  • 如果代码仅为了测试某项功能,并不想编写复杂的log4j.properties,可以使用Log4j提供的默认配置,在获取Logger前使用以下代码加载默认配置:BasicConfigurator.configure();
  • 查看configure()方法的源码:
/** Add a {@link ConsoleAppender} that uses {@link PatternLayout} using the {@link PatternLayout#TTCC_CONVERSION_PATTERN} and prints to <code>System.out</code> to the root category. */staticpublicvoid configure() { Logger root = Logger.getRootLogger(); root.addAppender(new ConsoleAppender(   new PatternLayout(PatternLayout.TTCC_CONVERSION_PATTERN)));}
  • 古早时期的源码格式有点不太现代,但意义明确:为RootLogger对象添加一个Appender,其中Appender的类型为控制器输出的ConsoleAppender,输出的格式使用PatternLayout.TTCC_CONVERSION_PATTERN
  • 以下为PatternLayout.TTCC_CONVERSION_PATTERN源码:
/** A conversion pattern equivalent to the TTCCCLayout. Current value is <b>%r [%t] %p %c %x - %m%n</b>. */public final static String TTCC_CONVERSION_PATTERN           = "%r [%t] %p %c %x - %m%n";
  • 关于PatternLayout的相关格式化规则,后续会列举出来。
  • 于是,使用以下代码加载默认配置并输出日志:
@Testpublic void testQuick() { // 1.初始化配置信息,使用默认的配置,如果不加载默认配置同时不具有log4j.properties配置文件,程序将发出警告 BasicConfigurator.configure(); // 2.获取日志记录器对象Logger Logger logger = Logger.getLogger(Log4jTest.class); // 3.日志记录输出 logger.info("Hey, log4j.");}
  • 此时控制台输出为:

日志级别

  • Log4j中的日志级别与JUL的不同,一共提供了6中日志级别:
    1. FATAL:严重错误,一般会造成系统崩溃并终止运行;
    2. ERROR:错误信息,不会影响系统运行;
    3. WARN:警告信息,可能会发生问题;
    4. INFO:运行信息,数据连接、网络连接、I/O操作等等;
    5. DEBUG:调试信息,一般在开发中使用,记录程序变量参数传递信息等等。默认级别;
    6. TRACE:追踪信息,记录程序所有的流程信息。
  • 参考以下示例代码:
@Testpublic void testQuick() { // 1.初始化配置信息,使用默认的配置,如果不加载默认配置同时不具有log4j.properties配置文件,程序将发出警告 BasicConfigurator.configure(); // 2.获取日志记录器对象Logger Logger logger = Logger.getLogger(Log4jTest.class); // 3.日志级别测试 logger.fatal("[FATAL] 严重错误,一般会造成系统崩溃并终止运行。"); logger.error("[ERROR] 错误信息,不会影响系统运行。"); logger.warn("[WARN] 警告信息,可能会发生问题。"); logger.info("[INFO] 运行信息,数据连接、网络连接、I/O操作等等。"); logger.debug("[DEBUG] 调试信息,一般在开发中使用,记录程序变量参数传递信息等等。默认级别。"); logger.trace("[TRACE] 追踪信息,记录程序所有的流程信息。");}
  • 运行输出,得到:

  • 输出的日志仍然由默认的日志级别所决定,其中默认级别为DEBUG
  • 为了测试默认日志级别,可以使用以下代码测试RootLogger
    1. 使用getRootLogger()获取RootLogger对象;
    2. 使用RootLogger中的相关方法获取日志对象的日志等级及其关联的Appender详情。
@Testpublic void testDetails() { // 1.初始化配置信息,使用默认的配置,如果不加载默认配置,将无法正常运行 BasicConfigurator.configure(); // 2.获取日志记录器对象RootLogger final Logger rootLogger = Logger.getRootLogger(); // 3.输出配置详情 System.out.println("Logger level: " + rootLogger.getLevel()); final Enumeration allAppenders = rootLogger.getAllAppenders(); while (allAppenders != null && allAppenders.hasMoreElements()) {  final Appender appender = (Appender) allAppenders.nextElement();  System.out.println("Appender is: " +appender.getClass().getSimpleName()); }}
  • 运行输出:

  • 注意,对于Log4j中的Appender来说,它们不具有日志等级,只有Logger对象具有日志等级。

Log4j相关组件

  • Log4J主要由Loggers (日志记录器)、Appenders(输出端)和Layout(日志格式化器)组成:
    • Loggers:控制日志的输出级别与日志是否输出;
    • Appenders:指定日志的输出方式(输出到控制台、文件等);
    • Layout:控制日志信息的输出格式。

a. Logger

  • 日志记录器,负责收集处理日志记录,Logger的实例命名通常是类的全限定类名。
  • Logger的名字大小写敏感,其命名有继承机制。
    • 例如:nameorg.apache.commonslogger会继承nameorg.apachelogger
  • log4j 1.2版以来, Logger类已经取代了Category类。对于熟悉早期版本的log4j的人来说,Logger类可以被视为Category类的别名。

b. Appenders

  • Appender用来指定日志输出到哪个地方,可以同时指定日志的输出目的地。
  • Log4j常用的输出目的地有以下几种:
输出端类型作用
ConsoleAppender将日志输出到控制台
FileAppender将日志输出到文件中
DailyRollingFileAppender将日志输出到一个日志文件,周期为天,即每天输出
RollingFileAppender将日志信息输出到一个日志文件,并且指定文件的大小,当超过指定大小,会自动将文件重命名,同时产生一个新的文件
JDBCAppender将日志信息保存到数据库中

c. Layouts

  • 布局器Layouts用于控制日志输出内容的格式,我们可以使用各种自定义格式输出日志。
  • Log4j常用的Layouts有以下几种:
格式化器类型作用
HTMLLayout格式化日志输出为HTML表格形式
SimpleLayout简单的日志输出格式,打印的日志格式为info-message
PatternLayout最强大的格式化方式,可以根据自定义格式输出日志,如果没有指定转换格式,则使用默认的转换格式
  • PatternLayout中的格式化规则:
* log4j采用类似C语言的printf函数的打印格式格式化日志信息,具体的占位符及其含义如下: %m 	输出代码中指定的日志信息 %p 	输出优先级,及DEBUG、INFO等 %n 	换行符(Windows平台的换行符为"\n",Unix平台为"\n") %r 	输出自应用启动到输出该 log 信息耗费的毫秒数 %c 	输出打印语句所属的类的全名 %t 	输出产生该日志的线程全名 %d 	输出服务器当前时间,默认为ISO8601,也可以指定格式,如:%d{yyyy年MM月dd日 HH:mm:ss} %l 	输出日志时间发生的位置,包括类名、线程、及在代码中的行数。如:Test.main(Test.java:10) %F 	输出日志消息产生时所在的文件名称 %L 	输出代码中的行号 %% 	输出一个"%"字符* 可以在%与字符之间加上修饰符来控制最小宽度、最大宽度和文本的对其方式。如: %5c 	输出category名称,最小宽度是5,category<5,默认的情况下右对齐 %-5c 	输出category名称,最小宽度是5,category<5,"-"号指定左对齐,会有空格 %.5c 	输出category名称,最大宽度是5,category>5,就会将左边多出的字符截掉,<5不会有空格 %20.30c category名称<20补空格,并且右对齐,>30字符,就从左边交远销出的字符截掉

自定义配置

  • 使用Log4j不需要显式地加载配置文件,对于Maven项目来说,程序会自动扫描resources目录下的log4j.properties配置文件。

  • 自定义配置如下:

    1. 日志输出等级为INFO,此时RootLogger拥有三个Appender
      1. ConsoleAppender:配置中的命名为Console
      2. DailyRollingFileAppender:配置中的命名为UserDefinedName
      3. JDBCAppender:配置中的命名为logDB
    2. RootLogger的默认输出级别配置在log4j.rootLogger的首位,随后紧跟的是关联的Appender的名称,表示其默认支持输出的方式有哪些。
# 指定日志的输出级别与输出端log4j.rootLogger=INFO, Console, UserDefinedName, logDB# 控制台输出配置log4j.appender.Console=org.apache.log4j.ConsoleAppenderlog4j.appender.Console.layout=org.apache.log4j.PatternLayoutlog4j.appender.Console.layout.ConversionPattern=%d [%t] %-5p [%c] - %m%n# 文件输出配置log4j.appender.UserDefinedName=org.apache.log4j.DailyRollingFileAppender# 指定日志的输出路径log4j.appender.UserDefinedName.File=log4j.log# 是否以追加日志的形式添加log4j.appender.UserDefinedName.Append=true# 使用自定义日志格式化器log4j.appender.UserDefinedName.layout=org.apache.log4j.PatternLayout# 指定日志的输出格式log4j.appender.UserDefinedName.layout.ConversionPattern=%-d{yyyy-MM-dd HH:mm:ss} [%t:%r] - [%p] %m%n# 指定日志的文件编码log4j.appender.UserDefinedName.encoding=UTF-8# MySQL输出配置log4j.appender.logDB=org.apache.log4j.jdbc.JDBCAppenderlog4j.appender.logDB.layout=org.apache.log4j.PatternLayoutlog4j.appender.logDB.Driver=com.mysql.cj.jdbc.Driverlog4j.appender.logDB.URL=jdbc:mysql://localhost:3306/test?serverTimezone=GMT%2B8&useAffectedRows=truelog4j.appender.logDB.User=rootlog4j.appender.logDB.Password=rootlog4j.appender.logDB.Sql=INSERT INTO log(project_name, create_date, level, category, file_name, thread_name, line, all_category, message) \ values('log4j', '%d{yyyy-MM-dd HH:mm:ss}', '%p', '%c', '%F', '%t', '%L', '%l', '%m')
  • 配置中包含了sql输出日志的方式,log表的创建代码为:
CREATE TABLE `log` (	`log_id` INT ( 11 ) NOT NULL AUTO_INCREMENT,	`project_name` VARCHAR ( 255 ) DEFAULT NULL COMMENT '项目名称',	`create_date` VARCHAR ( 255 ) DEFAULT NULL COMMENT '创建时间',	`level` VARCHAR ( 255 ) DEFAULT NULL COMMENT '优先级',	`category` VARCHAR ( 255 ) DEFAULT NULL COMMENT '所在类的全名',	`file_name` VARCHAR ( 255 ) DEFAULT NULL COMMENT '输出日志消息产生时所在的文件名称 ',	`thread_name` VARCHAR ( 255 ) DEFAULT NULL COMMENT '日志事件的线程名',	`line` VARCHAR ( 255 ) DEFAULT NULL COMMENT '行号',	`all_category` VARCHAR ( 255 ) DEFAULT NULL COMMENT '日志事件的发生位置',	`message` VARCHAR ( 4000 ) DEFAULT NULL COMMENT '输出代码中指定的消息',	PRIMARY KEY ( `log_id` ) );
  • 让特定名称的logger使用特定的配置:
    1. 一个log4j.properties中可以配置多个且可重复的Appender,但Appender的命名不可重复;
    2. 通过log4j.logger.{loggerName}的方式,让指定名为loggerNamelogger使用该配置;
    3. 由于该logger仍然是隶属于rootLogger,因此输出是累加的形式:
      • 例:如果RootLogger使用了ConsoleAppender,同时Logger也使用了ConsoleAppender,此时控制台将输出两次日志记录,一次为Logger继承自RootLogger的输出,另一次则为Logger自身的输出。
    4. 但日志等级level则取决于子日志LoggerRootLogger,以等级高的一方为准。
      • 例:此时RootLoggerLogger同时使用了ConsoleAppender,但输出等级分别为INFOWARN,此时控制台输出的日志等级仅有高于等于WARN的记录,即使此时RootLogger的等级为INFO
  • 有如下log4j.properties配置文件:
    • 其中RootLogger和名为cn.hannaLogger使用同一个ConsoleAppender,但日志等级不一致。
# 指定日志的输出级别与输出端log4j.rootLogger=INFO, Console# 控制台输出配置log4j.appender.Console=org.apache.log4j.ConsoleAppenderlog4j.appender.Console.layout=org.apache.log4j.PatternLayoutlog4j.appender.Console.layout.ConversionPattern=%d [%t] %-5p [%c] - %m%n# 让名为"cn.hanna"的logger使用名为Another的Appender# 此时仍会使用rootLogger中的控制台输出,而Level则以两者间较高的为准log4j.logger.cn.hanna=WARN, Console
  • 测试代码如下:
@Testpublic void testAnother() { // 1.获取日志记录器对象Logger Logger logger = Logger.getLogger("cn.hanna"); // 2.日志级别测试 logger.fatal("[FATAL] 严重错误,一般会造成系统崩溃并终止运行。"); logger.error("[ERROR] 错误信息,不会影响系统运行。"); logger.warn("[WARN] 警告信息,可能会发生问题。"); logger.info("[INFO] 运行信息,数据连接、网络连接、I/O操作等等。"); logger.debug("[DEBUG] 调试信息,一般在开发中使用,记录程序变量参数传递信息等等。默认级别。"); logger.trace("[TRACE] 追踪信息,记录程序所有的流程信息。");}
  • 运行输出:

  • 输出印证了之前所陈述的观点,不再赘述。
  • 此时,如果一定需要使用ConsoleAppender,但不希望控制台输出两次记录,有两种方式:
    1. 摒弃RootLogger的输出,即断开指定LoggerRootLogger的继承关系;
    2. 摒弃Logger的输出,即指定名称的Logger直接使用RootLogger关联的Appender,不再额外指定。
  • 如果选择断开指定LoggerRootLogger的继承关系,需修改配置文件如下:
# 指定日志的输出级别与输出端log4j.rootLogger=INFO, Console# 控制台输出配置log4j.appender.Console=org.apache.log4j.ConsoleAppenderlog4j.appender.Console.layout=org.apache.log4j.PatternLayoutlog4j.appender.Console.layout.ConversionPattern=%d [%t] %-5p [%c] - %m%n# 名为"cn.hanna"的Logger不再继承使用RootLogger中的Appenderlog4j.additivity.cn.hanna=falselog4j.logger.cn.hanna=WARN, Console
  • 如果选择直接使用RootLogger关联的Appender,需修改配置文件如下:
# 指定日志的输出级别与输出端log4j.rootLogger=INFO, Console# 控制台输出配置log4j.appender.Console=org.apache.log4j.ConsoleAppenderlog4j.appender.Console.layout=org.apache.log4j.PatternLayoutlog4j.appender.Console.layout.ConversionPattern=%d [%t] %-5p [%c] - %m%n# 对于名称"cn.hanna"的Logger来说,将直接使用RootLogger中关联的Appender,但日志等级由自身决定log4j.logger.cn.hanna=WARN
  • 两种方式的测试类运行结果均为:

  • 实际应用中,应该灵活选择适合与代码的方式,去编写配置文件。

完整的配置文件示例

  • 同样,在此给出一个完整的log4j配置文件示例:
log4j.rootLogger=INFO, Consolelog4j.appender.Console=org.apache.log4j.ConsoleAppenderlog4j.appender.Console.layout=org.apache.log4j.PatternLayoutlog4j.appender.Console.layout.ConversionPattern=%d [%t] %-5p [%c] - %m%nlog4j.appender.UserDefinedName=org.apache.log4j.DailyRollingFileAppenderlog4j.appender.UserDefinedName.File=log4j.loglog4j.appender.UserDefinedName.Append=truelog4j.appender.UserDefinedName.layout=org.apache.log4j.PatternLayoutlog4j.appender.UserDefinedName.layout.ConversionPattern=%-d{yyyy-MM-dd HH:mm:ss} [%t:%r] - [%p] %m%nlog4j.appender.UserDefinedName.encoding=UTF-8log4j.appender.logDB=org.apache.log4j.jdbc.JDBCAppenderlog4j.appender.logDB.layout=org.apache.log4j.PatternLayoutlog4j.appender.logDB.Driver=com.mysql.cj.jdbc.Driverlog4j.appender.logDB.URL=jdbc:mysql://localhost:3306/test?serverTimezone=GMT%2B8&useAffectedRows=truelog4j.appender.logDB.User=rootlog4j.appender.logDB.Password=rootlog4j.appender.logDB.Sql=INSERT INTO log(project_name, create_date, level, category, file_name, thread_name, line, all_category, message) \ values('log4j', '%d{yyyy-MM-dd HH:mm:ss}', '%p', '%c', '%F', '%t', '%L', '%l', '%m')log4j.appender.Another=org.apache.log4j.DailyRollingFileAppenderlog4j.appender.Another.File=hanna.loglog4j.appender.Another.Append=truelog4j.appender.Another.layout=org.apache.log4j.PatternLayoutlog4j.appender.Another.layout.ConversionPattern=%-d{yyyy-MM-dd HH:mm:ss} [%t:%r] - [%p] %m%nlog4j.appender.Another.encoding=UTF-8log4j.logger.cn.xyz=WARN, Anotherlog4j.additivity.cn.xyz=false
  • 说明:其中log4j.appeder.APPENDER_NAME中的APPENDER_NAME为相应Appender的名称,可以自行定义。

总结

  • Log4j日志框架近似于JUL日志框架,但功能性上要优于JUL


原文转载:http://www.shaoqun.com/a/504553.html

跨境电商:https://www.ikjzd.com/

tiki:https://www.ikjzd.com/w/2053

r标:https://www.ikjzd.com/w/1070


日志框架Log4j的使用介绍。简介本篇是关于Log4j日志框架的介绍。阅读本文请至少了解JUL日志框架,因为大部分的知识点是类似的。Log4j日志框架Log4j全称是LogforJava,它是Apache的一个开源项目,通过使用Log4j,我们可以控制日志信息输出的位置是控制台、文件还是GUI组件,输出位置甚至可以是套接口服务器、NT的事件记录器、UNIXSyslog守护进程等;使用Log4j也可
easy buy:easy buy
贝贝母婴网:贝贝母婴网
为什么卖房也要做亚马逊?这其中的暴利你了解吗?:为什么卖房也要做亚马逊?这其中的暴利你了解吗?
广东新丰云髻山红叶适合什么时候去?新丰云髻山红叶最佳时间?:广东新丰云髻山红叶适合什么时候去?新丰云髻山红叶最佳时间?
关务必看:11月海关经贸新规超全汇总!:关务必看:11月海关经贸新规超全汇总!

2020-12-30

中国十大最美女运动员:郭晶晶第七,惠若琪第三,榜首实至名归!_潘晓婷

原标题:中国十大最美女运动员:郭晶晶第七,惠若琪第三,榜首实至名归!

运动场上,我们总是会被颜值突出的女运动员吸引。本篇文章就来为您盘点一下国内十大最美女运动员。

10.赵静楠

赵静楠是中国艺术体操运动员,她成名很早,2013年和队友拿下第十二届全国运动会艺术体操全能金牌。随后她在一些国际重大赛事上也取得了不错的成绩。

9.何雯娜

何雯娜颜值和身材都非常出众,身为中国女子蹦床运动员,她有着蹦床公主的美誉。2008年北京奥运会拿到金牌为国争光。

8.赵爽

赵爽是中国女子篮球运动员,身高出众,技术扎实,而她较好的身材和容貌更是成为篮球场上的焦点。在整个世界女篮范围内,赵爽的颜值都是数一数二的。

7.郭晶晶

关于郭晶晶的荣誉,我们在此不过多赘述,年轻时她的颜值更是让人难以忘怀,尤其是她的侧颜非常优雅大气。退役后,郭晶晶也有着很高的知名度,毕竟她的气质太突出。

6.刘湘

刘湘是中国游泳运动员,2015年他在全国游泳冠军赛上一举夺魁,她的身材和面容都非常亮丽,出现在大屏幕前,让很多观众印象深刻

5.张常宁

张常宁是中国女子排球运动员,2016年她和中国女排拿到里约奥运会冠军,圈粉无数。她的身高为1米95。无论是在场上还是在场外都是人们关注的焦点。

4.张豆豆

张豆豆是中国艺术体操运动员,身为一名体操运动员,她的身材和容貌在此都不用质疑,最重要的是她的气质非常优雅,实力也非常优秀。

3.惠若琪

惠若琪绝对是中国女排的门面担当。不仅和中国队拿到了众多荣誉,她的颜值和身材更是鹤立鸡群。惠若琪一直给人一种阳光大气自信的感觉,在场上总是闲庭信步,同时敢打敢拼。身为中国女排队长的她有无数粉丝拥护。

2.赵丽娜

赵丽娜是本次榜单中比较特殊的一位。因为身为一个中国女足球员,她得到的影响并不算多,而且她的位置是守门员。可是,凭借自己扎实的技术以及姣好的容貌,她成为场上一道亮丽的风景。人们总是会不由自主的把目光停留在赵丽娜身上,她的身高也达到1米82,是一位高挑的运动员。

1.潘晓婷

要说中国体坛最漂亮的运动员大概率是潘晓婷。综合身材容貌气质三个方面,没有任何人能强过潘晓婷。潘晓婷虽然身高只有1米6,但是体态非常均匀,精致优雅,再加上得天独厚的气质,只要出现在台球场上,她就是人们关注的焦点。正因为潘晓婷的存在,花式九球也受到了人们越来越多的关注。可以说潘晓婷就是这项运动的门面担当。返回搜狐,查看更多

责任编辑:

原文转载:http://sport.shaoqun.com/a/380148.html

跨境电商:https://www.ikjzd.com/

史泰博:https://www.ikjzd.com/w/2112

慧聪集团:https://www.ikjzd.com/w/1836


原标题:中国十大最美女运动员:郭晶晶第七,惠若琪第三,榜首实至名归!运动场上,我们总是会被颜值突出的女运动员吸引。本篇文章就来为您盘点一下国内十大最美女运动员。10.赵静楠赵静楠是中国艺术体操运动员,她成名很早,2013年和队友拿下第十二届全国运动会艺术体操全能金牌。随后她在一些国际重大赛事上也取得了不错的成绩。9.何雯娜何雯娜颜值和身材都非常出众,身为中国女子蹦床运动员,她有着蹦床公主的美誉。2
网上1号店:网上1号店
indiegogo:indiegogo
学生票什么时候可以买?:学生票什么时候可以买?
2020年是什么年?:2020年是什么年?
南沙湿地公园中高考生免费吗?广州南沙湿地凭2020准考证有:南沙湿地公园中高考生免费吗?广州南沙湿地凭2020准考证有

分布式系统架构,回顾2020年常见面试知识点梳理(每次面试都会问到其中某一块知识点)

分布式分为分布式缓存(Redis)、分布式锁(Redis 或 Zookeeper)、分布式服务(Dubbo 或 SpringCloud)、分布式服务协调(Zookeeper)、分布式消息队列(Kafka 、RabbitMq)、分布式 Session 、分布式事务、分布式搜索(Elasticsearch)等。不可能所有分布式内容都熟悉,一定要在某个领域有所专长。

分布式理论

问:分布式有哪些理论?

CAP 、BASE。分布式 CAP 理论,任何一个分布式系统都无法同时满足 Consistency(一致性)、Availability(可用性)、Partition tolerance(分区容错性) 这三个基本需求。最多只能满足其中两项。而 Partition tolerance(分区容错性) 是必须的,因此一般是 CP ,或者 AP。

问:你怎么理解分布式一致性?

数据一致性通常指关联数据之间的逻辑关系是否正确和完整。在分布式系统中,数据一致性往往指的是由于数据的复制,不同数据节点中的数据内容是否完整并且相同。

一致性还分为强一致性,弱一致性,还有最终一致性。强一致性就是马上就保持一致。 最终一致性是指经过一段时间后,可以保持一致。

分布式事务

问:你怎么理解分布式事务?分布式事务的协议有哪些?

分布式事务是指会涉及到操作多个数据库的事务。目的是为了保证分布式系统中的数据一致性。分布式事务类型:二阶段提交 2PC ,三阶段提交 3PC。

  • 2PC :第一阶段:准备阶段(投票阶段)和第二阶段:提交阶段(执行阶段)。

  • 3PC :三个阶段:CanCommit 、PreCommit 、DoCommit。

问:分布式事务的解决方案有哪些?

分布式事务解决方案:补偿机制 TCC 、XA 、消息队列 MQ。

问:讲一下 TCC。

T(Try)锁资源:锁定某个资源,设置一个预备类的状态,冻结部分数据。

  • 比如,订单的支付状态,先把状态修改为"支付中(PAYING)"。

  • 比如,本来库存数量是 100 ,现在卖出了 2 个,不要直接扣减这个库存。在一个单独的冻结库存的字段,比如 prepare _ remove _ stock 字段,设置一个 2。也就是说,有 2 个库存是给冻结了。

  • 积分服务的也是同理,别直接给用户增加会员积分。你可以先在积分表里的一个预增加积分字段加入积分。

  • 比如:用户积分原本是 1190 ,现在要增加 10 个积分,别直接 1190 + 10 = 1200 个积分啊!你可以保持积分为 1190 不变,在一个预增加字段里,比如说 prepare _ add _ credit 字段,设置一个 10 ,表示有 10 个积分准备增加。

C(Confirm):在各个服务里引入了一个 TCC 分布式事务的框架,事务管理器可以感知到各个服务的 Try 操作是否都成功了。假如都成功了, TCC 分布式事务框架会控制进入 TCC 下一个阶段,第一个 C 阶段,也就是 Confirm 阶段。此时,需要把 Try 阶段锁住的资源进行处理。

  • 比如,把订单的状态设置为"已支付(Payed)"。

  • 比如,扣除掉相应的库存。

  • 比如,增加用户积分。

C(Cancel):在 Try 阶段,假如某个服务执行出错,比如积分服务执行出错了,那么服务内的 TCC 事务框架是可以感知到的,然后它会决定对整个 TCC 分布式事务进行回滚。

TCC 分布式事务框架只要感知到了任何一个服务的 Try 逻辑失败了,就会跟各个服务内的 TCC 分布式事务框架进行通信,然后调用各个服务的 Cancel 逻辑。也就是说,会执行各个服务的第二个 C 阶段, Cancel 阶段。

  • 比如,订单的支付状态,先把状态修改为" closed "状态。

  • 比如,冻结库存的字段, prepare _ remove _ stock 字段,将冻结的库存 2 清零。

  • 比如,预增加积分的字段, prepare _ add _ credit 字段,将准备增加的积分 10 清零。

问:事务管理器宕掉了,怎么办?

做冗余,设置多个事务管理器,一个宕掉了,其他的还可以用。

问:怎么保证分布式系统的幂等性?

状态机制。版本号机制。

Redis

问:Redis 有哪些优势?

  1. 速度快,因为数据存在内存中。

  2. 支持丰富数据类型,支持 string、list、set 、sorted set、hash。

  3. 支持事务,操作都是原子性,所谓的原子性就是对数据的更改要么全部执行,要么全部不执行。

  4. 丰富的特性:可用于缓存,消息,按 key 设置过期时间,过期后将会自动删除。

  5. 单线程,单进程,采用 IO 多路复用技术。

问:Redis 的存储结构是怎样的?

key-value 键值对。

问:Redis 支持哪些数据结构?

string(字符串), hash(哈希), list(队列), set(集合)及 zset(sorted set 有序集合)。

问:Redis 的数据结构,有哪些应用场景?

  • string:简单地 get / set 缓存。

  • hash:可以缓存用户资料。比如命令:hmset user1 name "lin" sex "male" age "25" ,缓存用户 user1 的资料,姓名为 lin ,性别为男,年龄 25。

  • list:可以做队列。往 list 队列里面 push 数据,然后再 pop 出来。

  • zset:可以用来做排行榜。

问:Redis 的数据结构,底层分别是由什么实现的?

  • Redis 字符串,却不是 C 语言中的字符串(即以空字符 '\0' 结尾的字符数组),它是自己构建了一种名为 简单动态字符串(simple dynamic string , SDS)的抽象类型,并将 SDS 作为 Redis 的默认字符串表示。

  • Redi List ,底层是 ZipList ,不满足 ZipList 就使用双向链表。ZipList 是为了节约内存而开发的。和各种语言的数组类似,它是由连续的内存块组成的,这样一来,由于内存是连续的,就减少了很多内存碎片和指针的内存占用,进而节约了内存。

问:Redis 怎么保证可靠性?Redis 的持久化方式有哪些?有哪些优缺点?

一个可靠安全的系统,肯定要考虑数据的可靠性,尤其对于内存为主的 Redis ,就要考虑一旦服务器挂掉,启动之后,如何恢复数据的问题,也就是说数据如何持久化的问题。 AOF 就是备份操作记录。AOF 由于是备份操作命令,备份快、恢复慢。 AOF 的优点:AOF 更好保证数据不会被丢失,最多只丢失一秒内的数据。另外重写操作保证了数据的有效性,即使日志文件过大也会进行重写。AOF 的日志文件的记录可读性非常的高。 AOF 的缺点:对于相同数量的数据集而言, AOF 文件通常要大于 RDB 文件。 RDB 就是备份所有数据,使用了快照。RDB 恢复数据比较快。

问:AOF 文件过大,怎么处理?

会进行 AOF 文件重写。

  • 随着 AOF 文件越来越大,里面会有大部分是重复命令或者可以合并的命令。

  • 重写的好处:减少 AOF 日志尺寸,减少内存占用,加快数据库恢复时间。

执行一个 AOF 文件重写操作,重写会创建一个当前 AOF 文件的体积优化版本。

问:讲一下 Redis 的事务。

先以 MULTI 开始一个事务, 然后将多个命令入队到事务中, 最后由 EXEC 命令触发事务, 一并执行事务中的所有命令。如果想放弃这个事务,可以使用 DISCARD 命令。

问:Redis 事务无法回滚,那怎么处理? 问:怎么设置 Redis 的 key 过期时间?

key 的的过期时间通过 EXPIRE key seconds 命令来设置数据的过期时间。返回 1 表明设置成功,返回 0 表明 key 不存在或者不能成功设置过期时间。

问:Redis 的过期策略有哪些?

惰性删除:当读/写一个已经过期的 key 时,会触发惰性删除策略,直接删除掉这个过期 key ,并按照 key 不存在去处理。惰性删除,对内存不太好,已经过期的 key 会占用太多的内存。 定期删除:每隔一段时间,就会对 Redis 进行检查,主动删除一批已过期的 key。

问:为什么 Redis 不使用定时删除?

定时删除,就是在设置 key 的过期时间的同时,创建一个定时器,让定时器在过期时间来临时,立即执行对 key 的删除操作。 定时删会占用 CPU ,影响服务器的响应时间和性能。

问:Redis 的内存回收机制都有哪些?

当前已用内存超过 maxmemory 限定时,会触发主动清理策略,也就是 Redis 的内存回收策略。 LRU 、TTL。 noeviction :默认策略,不会删除任何数据,拒绝所有写入操作并返回客户端错误信息,此时 Redis 只响应读操作。

  • volatitle - lru :根据 LRU 算法删除设置了超时属性的键,知道腾出足够空间为止。如果没有可删除的键对象,回退到 noeviction 策略。

  • allkeys - lru :根据 LRU 算法删除键,不管数据有没有设置超时属性,直到腾出足够空间为止。

  • allkeys - random :随机删除所有键,知道腾出足够空间为止。

  • volatitle - random :随机删除过期键,知道腾出足够空间为止。

  • volatitle - ttl :根据键值对象的 ttl 属性,删除最近将要过期数据。如果没有,回退到 noeviction 策略。

问:手写一下 LRU 算法。 问:Redis 的搭建有哪些模式?

主从模式、哨兵模式、Cluster(集群)模式。最好是用集群模式。

问:你用过的 Redis 是多主多从的,还是一主多从的?集群用到了多少节点?用到了多少个哨兵?

集群模式。三主三从。

问:Redis 采用多主多从的集群模式,各个主节点的数据是否一致?

问:Redis 集群有哪些特性

master 和 slaver。主从复制。读写分离。哨兵模式。

问:Redis 是怎么进行水平扩容的? 问:Redis 集群数据分片的原理是什么?

Redis 数据分片原理是哈希槽(hash slot)。

Redis 集群有 16384 个哈希槽。每一个 Redis 集群中的节点都承担一个哈希槽的子集。

哈希槽让在集群中添加和移除节点非常容易。例如,如果我想添加一个新节点 D ,我需要从节点 A 、B、C 移动一些哈希槽到节点 D。同样地,如果我想从集群中移除节点 A ,我只需要移动 A 的哈希槽到 B 和 C。当节点 A 变成空的以后,我就可以从集群中彻底删除它。因为从一个节点向另一个节点移动哈希槽并不需要停止操作,所以添加和移除节点,或者改变节点持有的哈希槽百分比,都不需要任何停机时间(downtime)。

问:讲一下一致性 Hash 算法。

一致性 Hash 算法将整个哈希值空间组织成一个虚拟的圆环, 我们对 key 进行哈希计算,使用哈希后的结果对 2 ^ 32 取模,hash 环上必定有一个点与这个整数对应。依此确定此数据在环上的位置,从此位置沿环顺时针"行走",第一台遇到的服务器就是其应该定位到的服务器。 一致性 Hash 算法对于节点的增减都只需重定位环空间中的一小部分数据,具有较好的容错性和可扩展性。 比如,集群有四个节点 Node A 、B 、C 、D ,增加一台节点 Node X。Node X 的位置在 Node B 到 Node C 直接,那么受到影响的仅仅是 Node B 到 Node X 间的数据,它们要重新落到 Node X 上。 所以一致性哈希算法对于容错性和扩展性有非常好的支持。

问:为什么 Redis Cluster 分片不使用 Redis 一致性 Hash 算法?

一致性哈希算法也有一个严重的问题,就是数据倾斜。 如果在分片的集群中,节点太少,并且分布不均,一致性哈希算法就会出现部分节点数据太多,部分节点数据太少。也就是说无法控制节点存储数据的分配。

问:集群的拓扑结构有没有了解过?集群是怎么连接的?

无中心结构。Redis-Cluster 采用无中心结构,每个节点保存数据和整个集群状态,每个节点都和其他所有节点连接。

问:讲一下 Redis 主从复制的过程。

从机发送 SYNC(同步)命令,主机接收后会执行 BGSAVE(异步保存)命令备份数据。

主机备份后,就会向从机发送备份文件。主机之后还会发送缓冲区内的写命令给从机。 当缓冲区命令发送完成后,主机执行一条写命令,就会往从机发送同步写入命令。

问:讲一下 Redis 哨兵机制。

下面是 Redis 官方文档对于哨兵功能的描述:

  • 监控(Monitoring):哨兵会不断地检查主节点和从节点是否运作正常。

  • 自动故障转移(Automatic Failover):当主节点不能正常工作时,哨兵会开始自动故障转移操作,它会将失效主节点的其中一个从节点升级为新的主节点,并让其他从节点改为复制新的主节点。

  • 配置提供者(Configuration Provider):客户端在初始化时,通过连接哨兵来获得当前 Redis 服务的主节点地址。

  • 通知(Notification):哨兵可以将故障转移的结果发送给客户端。

问:讲一下布隆过滤器。

布隆过滤器的主要是由一个很长的二进制向量和若干个(k 个)散列映射函数组成。因为每个元数据的存储信息值固定,而且总的二进制向量固定。所以在内存占用和查询时间上都远远超过一般的算法。当然存在一定的不准确率(可以控制)和不容易删除样本数据。 布隆过滤器的优点:大批量数据去重,特别的占用内存。但是用布隆过滤器(Bloom Filter)会非常的省内存。 布隆过滤器的特点:当布隆过滤器说某个值存在时,那可能就不存在,如果说某个值不存在时,那肯定就是不存在了。 布隆过滤器的应用场景:新闻推送(不重复推送)。解决缓存穿透的问题。

缓存

问:缓存雪崩是什么?

如果缓存数据设置的过期时间是相同的,并且 Redis 恰好将这部分数据全部删光了。这就会导致在这段时间内,这些缓存同时失效,全部请求到数据库中。这就是缓存雪崩。

问:怎么解决缓存雪崩?

解决方法:在缓存的时候给过期时间加上一个随机值,这样就会大幅度的减少缓存在同一时间过期。

问:缓存穿透是什么?

缓存穿透是指查询一个一定不存在的数据。由于缓存不命中,并且出于容错考虑,如果从数据库查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到数据库去查询,失去了缓存的意义。

问:怎么解决缓存穿透?

问:什么是缓存与数据库双写一致问题?

问:如何保证缓存与数据库的一致性?

读的时候,先读缓存,缓存没有的话,就读数据库,然后取出数据后放入缓存,同时返回响应。

先删除缓存,再更新数据库。

问:为什么是先删除缓存,而不是先更新缓存?

问:先更新数据库,再删除缓存,会有什么问题?

先更新数据库,再删除缓存。可能出现以下情况:

  • 如果更新完数据库, Java 服务提交了事务,然后挂掉了,那 Redis 还是会执行,这样也会不一致。

  • 如果更新数据库成功,删除缓存失败了,那么会导致数据库中是新数据,缓存中是旧数据,数据就出现了不一致。

先删除缓存,再更新数据库。

  • 如果删除缓存失败,那就不更新数据库,缓存和数据库的数据都是旧数据,数据是一致的。

  • 如果删除缓存成功,而数据库更新失败了,那么数据库中是旧数据,缓存中是空的,数据不会不一致。因为读的时候缓存没有,所以去读了数据库中的旧数据,然后更新到缓存中。

问:先删除缓存,在写数据库成功之前,如果有读请求发生,可能导致旧数据入缓存,引发数据不一致,怎么处理?

分布式锁

问:Redis 如何实现分布式锁?

使用 set key value ex nx 命令。

  • 当 key 不存在时,将 key 的值设为 value ,返回 1。若给定的 key 已经存在,则 setnx 不做任何动作,返回 0。

  • 当 setnx 返回 1 时,表示获取锁,做完操作以后 del key ,表示释放锁,如果 setnx 返回 0 表示获取锁失败。

详细的命令如下:

set key value [EX seconds] [PX milliseconds] [NX|XX]EX seconds:设置失效时长,单位秒PX milliseconds:设置失效时长,单位毫秒NX:key不存在时设置value,成功返回OK,失败返回(nil)XX:key存在时设置value,成功返回OK,失败返回(nil)。复制代码

示例如下:

set name fenglin ex 100 nx复制代码

问:为什么不先 set nx ,然后再使用 expire 设置超时时间?

我们需要保证 setnx 命令和 expire 命令以原子的方式执行,否则如果客户端执行 setnx 获得锁后,这时客户端宕机了,那么这把锁没有设置过期时间,导致其他客户端永远无法获得锁了。

问:使用 Redis 分布式锁, key 和 value 分别设置成什么?

value 可以使用 json 格式的字符串,示例:

{ "count":1, "expireAt":147506817232, "jvmPid":22224, "mac":"28-D2-44-0E-0D-9A", "threadId":14}复制代码

问:Redis 实现的分布式锁,如果某个系统获取锁后,宕机了怎么办?

系统模块宕机的话,可以通过设置过期时间(就是设置缓存失效时间)解决。系统宕机时锁阻塞,过期后锁释放。 问:设置缓存失效时间,那如果前一个线程把这个锁给删除了呢?

问:如果加锁和解锁之间的业务逻辑执行的时间比较长,超过了锁过期的时间,执行完了,又删除了锁,就会把别人的锁给删了。怎么办?

这两个属于锁超时的问题。

可以将锁的 value 设置为 Json 字符串,在其中加入线程的 id 或者请求的 id ,在删除之前, get 一下这个 key ,判断 key 对应的 value 是不是当前线程的。只有是当前线程获取的锁,当前线程才可以删除。

问:Redis 分布式锁,怎么保证可重入性?

可以将锁的 value 设置为 Json 字符串,在其中加入线程的 id 和 count 变量。

  • 当 count 变量的值为 0 时,表示当前分布式锁没有被线程占用。

  • 如果 count 变量的值大于 0 ,线程 id 不是当前线程,表示当前分布式锁已经被其他线程占用。

  • 如果 count 变量的值大于 0 ,线程 id 是当前线程的 id ,表示当前线程已经拿到了锁,不必阻塞,可以直接重入,并将 count 变量的值加一即可。

这种思路,其实就是参考了 ReentrantLock 可重入锁的机制。

问:Redis 做分布式锁, Redis 做了主从,如果设置锁之后,主机在传输到从机的时候挂掉了,从机还没有加锁信息,如何处理?

可以使用开源框架 Redisson ,采用了 redLock。

问:讲一下 Redis 的 redLock。 问:Zookeeper 是怎么实现分布式锁的?

分布式锁:基于 Zookeeper 一致性文件系统,实现锁服务。锁服务分为保存独占及时序控制两类。

  • 保存独占:将 Zookeeper 上的一个 znode 看作是一把锁,通过 createznode 的方式来实现。所有客户端都去创建 / distribute _ lock 节点,最终成功创建的那个客户端也即拥有了这把锁。用完删除自己创建的 distribute _ lock 节点就释放锁。

  • 时序控制:基于/ distribute _ lock 锁,所有客户端在它下面创建临时顺序编号目录节点,和选 master 一样,编号最小的获得锁,用完删除,依次方便。

更详细的回答如下:

其实基于 Zookeeper ,就是使用它的临时有序节点来实现的分布式锁。

原理就是:当某客户端要进行逻辑的加锁时,就在 Zookeeper 上的某个指定节点的目录下,去生成一个唯一的临时有序节点, 然后判断自己是否是这些有序节点中序号最小的一个,如果是,则算是获取了锁。如果不是,则说明没有获取到锁,那么就需要在序列中找到比自己小的那个节点,并对其调用 exist() 方法,对其注册事件监听,当监听到这个节点被删除了,那就再去判断一次自己当初创建的节点是否变成了序列中最小的。如果是,则获取锁,如果不是,则重复上述步骤。

当释放锁的时候,只需将这个临时节点删除即可。

Zookeeper

问:Zookeeper 的原理是什么?

问:Zookeeper 是怎么保证一致性的?

zab 协议。

zab 协议有两种模式,它们分别是恢复模式(选主)和广播模式(同步)。当服务启动或者在领导者崩溃后, zab 就进入了恢复模式,当领导者被选举出来,且大多数 server 完成了和 leader 的状态同步以后,恢复模式就结束了。状态同步保证了 leader 和 server 具有相同的系统状态。

问:Zookeeper 有哪些应用场景?

Zookeeper 可以作为服务协调的注册中心。还可以做分布式锁(如果没有用过分布式锁就不要说)。

问:Zookeeper 为什么能做注册中心?

Zookeeper 的数据模型是树型结构,由很多数据节点组成, zk 将全量数据存储在内存中,可谓是高性能,而且支持集群,可谓高可用。另外支持事件监听(watch 命令)。

Zookeeper 可以作为一个数据发布/订阅系统。

问:Zookeeper 的节点有哪些类型?有什么区别?

临时节点,永久节点。更加细分就是临时有序节点、临时无序节点、永久有序节点、永久无序节点。  

临时节点:当创建临时节点的程序停掉之后,这个临时节点就会消失,存储的数据也没有了。

问:Zookeeper 做为注册中心,主要存储哪些数据?存储在哪里?

IP、端口、还有心跳机制。数据存储在 Zookeeper 的节点上面。

问:心跳机制有什么用? 问:Zookeeper 的广播模式有什么缺陷?

广播风暴。

问:讲一下 Zookeeper 的读写机制。

  • Leader 主机负责读和写。

  • Follower 负责读,并将写操作转发给 Leader。Follower 还参与 Leader 选举投票,参与事务请求 Proposal 投票。

  • Observer 充当观察者的角色。Observer 和 Follower 的唯一区别在于:Observer 不参与任何投票。

问:讲一下 Zookeeper 的选举机制。

Leader 不可用时,会重新选举 Leader。超过半数的 Follower 选举投票即可,Observer 不参与投票。

问:你们的 Zookeeper 集群配置了几个节点?

3 个节点。注意:Zookeeper 集群节点,最好是奇数个的。

集群中的 Zookeeper 节点需要超过半数,整个集群对外才可用。

这里所谓的整个集群对外才可用,是指整个集群还能选出一个 Leader 来, Zookeeper 默认采用 quorums 来支持 Leader 的选举。

如果有 2 个 Zookeeper,那么只要有 1 个死了 Zookeeper 就不能用了,因为 1 没有过半,所以 2 个 Zookeeper 的死亡容忍度为 0 ;同理,要是有 3 个 Zookeeper,一个死了,还剩下 2 个正常的,过半了,所以 3 个 Zookeeper 的容忍度为 1 ;同理你多列举几个:2 -> 0 ; 3 -> 1 ; 4 -> 1 ; 5 -> 2 ; 6 -> 2 会发现一个规律, 2n 和 2n - 1 的容忍度是一样的,都是 n - 1 ,所以为了更加高效,何必增加那一个不必要的 Zookeeper 呢。

问:Zookeeper 的集群节点,如果不是奇数可能会出现什么问题?

可能会出现脑裂。

  • 假死:由于心跳超时(网络原因导致的)认为 master 死了,但其实 master 还存活着。

  • 脑裂:由于假死会发起新的 master 选举,选举出一个新的 master ,但旧的 master 网络又通了,导致出现了两个 master ,有的客户端连接到老的 master 有的客户端链接到新的 master。

消息队列

问:为什么使用消息队列?消息队列有什么优点和缺点?Kafka 、ActiveMQ 、RabbitMq 、RocketMQ 都有什么优点和缺点?

消息队列解耦,削峰,限流。

问:如何保证消息队列的高可用?(多副本)

问:如何保证消息不被重复消费?(如何保证消息消费的幂等性)

问:如何保证消息的可靠性传输?(如何处理消息丢失的问题)

问:如何保证消息的顺序性?

问:如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决?

问:如果让你写一个消息队列,该如何进行架构设计啊?说一下你的思路。

答案

Kafka

问:讲一下 Kafka。

Kafka 的简单理解

问:Kafka 相对其他消息队列,有什么特点?

  • 持久化:Kafka 的持久化能力比较好,通过磁盘持久化。而 RabbitMQ 是通过内存持久化的。

  • 吞吐量:Rocket 的并发量非常高。

  • 消息处理:RabbitMQ 的消息不支持批量处理,而 RocketMQ 和 Kafka 支持批量处理。

  • 高可用:RabbitMQ 采用主从模式。Kafka 也是主从模式,通过 Zookeeper 管理,选举 Leader ,还有 Replication 副本。

  • 事务:RocketMQ 支持事务,而 Kafka 和 RabbitMQ 不支持。

问:Kafka 有哪些模式?

如果一个生产者或者多个生产者产生的消息能够被多个消费者同时消费的情况,这样的消息队列称为"发布订阅模式"的消息队列。

问:Kafka 作为消息队列,有哪些优势?

分布式的消息系统。

高吞吐量。即使存储了许多 TB 的消息,它也保持稳定的性能。 数据保留在磁盘上,因此它是持久的。

问:Kafka 为什么处理速度会很快?kafka 的吞吐量为什么高?

  • 零拷贝:Kafka 实现了"零拷贝"原理来快速移动数据,避免了内核之间的切换。

  • 消息压缩、分批发送:Kafka 可以将数据记录分批发送,从生产者到文件系统(Kafka 主题日志)到消费者,可以端到端的查看这些批次的数据。

  • 批处理能够进行更有效的数据压缩并减少 I / O 延迟。

  • 顺序读写:Kafka 采取顺序写入磁盘的方式,避免了随机磁盘寻址的浪费。

问:讲一下 Kafka 中的零拷贝。

数据的拷贝从内存拷贝到 kafka 服务进程那块,又拷贝到 socket 缓存那块,整个过程耗费的时间比较高, kafka 利用了 Linux 的 sendFile 技术(NIO),省去了进程切换和一次数据拷贝,让性能变得更好。

问:Kafka 的偏移量是什么?

消费者每次消费数据的时候,消费者都会记录消费的物理偏移量(offset)的位置。等到下次消费时,他会接着上次位置继续消费

问:Kafka 的生产者,是如何发送消息的?

  • 生产者的消息是先被写入分区中的缓冲区中,然后分批次发送给 Kafka Broker。

  • 生产者的消息发送机制,有同步发送和异步发送。

  • 同步发送消息都有个问题,那就是同一时间只能有一个消息在发送,这会造成许多消息。

  • 无法直接发送,造成消息滞后,无法发挥效益最大化。

  • 异步发送消息的同时能够对异常情况进行处理,生产者提供了 Callback 回调。

问:Kafka 生产者发送消息,有哪些分区策略?

Kafka 的分区策略指的就是将生产者发送到哪个分区的算法。有顺序轮询、随机轮询、key - ordering 策略。

key - ordering 策略:Kafka 中每条消息都会有自己的 key ,一旦消息被定义了 Key ,那么你就可以保证同一个 Key 的所有消息都进入到相同的分区里面,由于每个分区下的消息处理都是有顺序的,故这个策略被称为按消息键保序策略。

问:Kafka 为什么要分区?

实现负载均衡和水平扩展。Kafka 可以将主题(Topic)划分为多个分区(Partition),会根据分区规则选择把消息存储到哪个分区中,只要如果分区规则设置的合理,那么所有的消息将会被均匀的分布到不同的分区中,这样就实现了负载均衡和水平扩展。另外,多个订阅者可以从一个或者多个分区中同时消费数据,以支撑海量数据处理能力。

问:Kafka 是如何在 Broker 间分配分区的?

在 broker 间平均分布分区副本。

假设有 6 个 broker ,打算创建一个包含 10 个分区的 Topic ,复制系数为 3 ,那么 Kafka 就会有 30 个分区副本,它可以被分配给这 6 个 broker ,这样的话,每个 broker 可以有 5 个副本。

要确保每个分区的每个副本分布在不同的 broker 上面:

假设 Leader 分区 0 会在 broker1 上面, Leader 分区 1 会在 broker2 上面, Leder 分区 2 会在 broker3 上面。

接下来会分配跟随者副本。如果分区 0 的第一个 Follower 在 broker2 上面,第二个 Follower 在 broker3 上面。分区 1 的第一个 Follower 在 broker3 上面,第二个 Follower 在 broker4 上面。

问:Kafka 如何保证消息的顺序性?

Kafka 可以保证同一个分区里的消息是有序的。也就是说消息发送到一个 Partition 是有顺序的。

问:Kafka 的消费者群组 Consumer Group 订阅了某个 Topic ,假如这个 Topic 接收到消息并推送,那整个消费者群组能收到消息吗?

Kafka 官网中有这样一句" Consumers label themselves with a consumer group name , and each record published to a topic is delivered to one consumer instance within each subscribing consumer group . "

表示推送到 topic 上的 record ,会被传递到已订阅的消费者群组里面的一个消费者实例。

问:如何提高 Kafka 的消费速度?

问:Kafka 出现消息积压,有哪些原因?怎么解决?

出现消息积压,可能是因为消费的速度太慢。

扩容消费者。之所以消费延迟大,就是消费者处理能力有限,可以增加消费者的数量。 扩大分区。一个分区只能被消费者群组中的一个消费者消费。消费者扩大,分区最好多随之扩大。

问:Kafka 消息消费者宕机了,怎么确认有没有收到消息?

ACK 机制,如果接收方收到消息后,会返回一个确认字符。

问:讲一下 Kafka 的 ACK 机制。

acks 参数指定了要有多少个分区副本接收消息,生产者才认为消息是写入成功的。此参数对消息丢失的影响较大。

如果 acks = 0 ,就表示生产者也不知道自己产生的消息是否被服务器接收了,它才知道它写成功了。如果发送的途中产生了错误,生产者也不知道,它也比较懵逼,因为没有返回任何消息。这就类似于 UDP 的运输层协议,只管发,服务器接受不接受它也不关心。

如果 acks = 1 ,只要集群的 Leader 接收到消息,就会给生产者返回一条消息,告诉它写入成功。如果发送途中造成了网络异常或者 Leader 还没选举出来等其他情况导致消息写入失败,生产者会受到错误消息,这时候生产者往往会再次重发数据。因为消息的发送也分为 同步 和 异步, Kafka 为了保证消息的高效传输会决定是同步发送还是异步发送。如果让客户端等待服务器的响应(通过调用 Future 中的 get() 方法),显然会增加延迟,如果客户端使用回调,就会解决这个问题。

如果 acks = all ,这种情况下是只有当所有参与复制的节点都收到消息时,生产者才会接收到一个来自服务器的消息。不过,它的延迟比 acks = 1 时更高,因为我们要等待不只一个服务器节点接收消息。

问:Kafka 如何避免消息丢失?

1、生产者丢失消息的情况

生产者(Producer) 调用 send 方法发送消息之后,消息可能因为网络问题并没有发送过去。

所以,我们不能默认在调用 send 方法发送消息之后消息消息发送成功了。为了确定消息是发送成功,我们要判断消息发送的结果。可以采用为其添加回调函数的形式,获取回调结果。

如果消息发送失败的话,我们检查失败的原因之后重新发送即可!可以设置 Producer 的 retries(重试次数)为一个比较合理的值,一般是 3 ,但是为了保证消息不丢失的话一般会设置比较大一点。

设置完成之后,当出现网络问题之后能够自动重试消息发送,避免消息丢失。

2、消费者丢失消息的情况

当消费者拉取到了分区的某个消息之后,消费者会自动提交了 offset。自动提交的话会有一个问题,试想一下,当消费者刚拿到这个消息准备进行真正消费的时候,突然挂掉了,消息实际上并没有被消费,但是 offset 却被自动提交了。手动关闭闭自动提交 offset ,每次在真正消费完消息之后之后再自己手动提交 offset 。

3 、Kafka 丢失消息

a、假如 leader 副本所在的 broker 突然挂掉,那么就要从 follower 副本重新选出一个 leader ,但是 leader 的数据还有一些没有被 follower 副本的同步的话,就会造成消息丢失。因此可以设置 ack = all。

b、设置 replication . factor >= 3 。为了保证 leader 副本能有 follower 副本能同步消息,我们一般会为 topic 设置 replication . factor >= 3。这样就可以保证每个 分区(partition) 至少有 3 个副本。虽然造成了数据冗余,但是带来了数据的安全性。

问:Kafka 怎么保证可靠性?

多副本以及 ISR 机制。

在 Kafka 中主要通过 ISR 机制来保证消息的可靠性。

ISR(in sync replica):是 Kafka 动态维护的一组同步副本,在 ISR 中有成员存活时,只有这个组的成员才可以成为 leader ,内部保存的为每次提交信息时必须同步的副本(acks = all 时),每当 leader 挂掉时,在 ISR 集合中选举出一个 follower 作为 leader 提供服务,当 ISR 中的副本被认为坏掉的时候,会被踢出 ISR ,当重新跟上 leader 的消息数据时,重新进入 ISR。

问:什么是 HW ?

HW(high watermark):副本的高水印值, replica 中 leader 副本和 follower 副本都会有这个值,通过它可以得知副本中已提交或已备份消息的范围, leader 副本中的 HW ,决定了消费者能消费的最新消息能到哪个 offset。

问:什么是 LEO ?

LEO(log end offset):日志末端位移,代表日志文件中下一条待写入消息的 offset ,这个 offset 上实际是没有消息的。不管是 leader 副本还是 follower 副本,都有这个值。

问:Kafka 怎么保证一致性?(存疑)

一致性定义:若某条消息对 client 可见,那么即使 Leader 挂了,在新 Leader 上数据依然可以被读到。 HW - HighWaterMark : client 可以从 Leader 读到的最大 msg offset ,即对外可见的最大 offset , HW = max(replica . offset)

对于 Leader 新收到的 msg , client 不能立刻消费, Leader 会等待该消息被所有 ISR 中的 replica 同步后,更新 HW ,此时该消息才能被 client 消费,这样就保证了如果 Leader fail ,该消息仍然可以从新选举的 Leader 中获取。 对于来自内部 Broker 的读取请求,没有 HW 的限制。同时, Follower 也会维护一份自己的 HW , Folloer . HW = min(Leader . HW , Follower . offset).

问:Kafka 怎么处理重复消息?怎么避免重复消费?

偏移量 offset :消费者每次消费数据的时候,消费者都会记录消费的物理偏移量(offset)的位置。等到下次消费时,他会接着上次位置继续消费。 一般情况下, Kafka 重复消费都是由于未正常提交 offset 造成的,比如网络异常,消费者宕机之类的。 使用的是 spring-Kafka ,所以把 Kafka 消费者的配置 enable.auto. commit 设为 false ,禁止 Kafka 自动提交 offset ,从而使用 spring-Kafka 提供的 offset 提交策略。

sprin-Kafka 中的 offset 提交策略可以保证一批消息数据没有完成消费的情况下,也能提交 offset ,从而避免了提交失败而导致永远重复消费的问题。

问:怎么避免重复消费?

将消息的唯一标识保存起来,每次消费时判断是否处理过即可。

问:如何保证消息不被重复消费?(如何保证消息消费的幂等性)

怎么保证消息队列消费的幂等性?其实还是得结合业务来思考,有几个思路: 比如你拿个数据要写库,你先根据主键查一下,如果这数据都有了,你就别插入了, update 一下好吧。 比如你是写 Redis ,那没问题了,反正每次都是 set ,天然幂等性。 如果是复杂一点的业务,那么每条消息加一个全局唯一的 id ,类似订单 id 之类的东西,然后消费到了之后,先根据这个 id 去比如 Redis 里查一下,之前消费过吗? 如果没有消费过,你就处理,然后这个 id 写 Redis。如果消费过了,那你就别处理了,保证别重复处理相同的消息即可。

问:Kafka 消息是采用 pull 模式,还是 push 模式?

pull 模式。

问:pull 模式和 push 模式,各有哪些特点?

pull 模式,准确性?可以较大保证消费者能获取到消息。

push 模式,即时性?可以在 broker 获取消息后马上送达消费者。

问:Kafka 是如何存储消息的?

Kafka 使用日志文件的方式来保存生产者和发送者的消息,每条消息都有一个 offset 值来表示它在分区中的偏移量。

Kafka 中存储的一般都是海量的消息数据,为了避免日志文件过大, 一个分片并不是直接对应在一个磁盘上的日志文件,而是对应磁盘上的一个目录。 数据存储设计的特点在于以下几点:

  1. Kafka 把主题中一个分区划分成多个分段的小文件段,通过多个小文件段,就容易根据偏移量查找消息、定期清除和删除已经消费完成的数据文件,减少磁盘容量的占用;

  2. 采用稀疏索引存储的方式构建日志的偏移量索引文件,并将其映射至内存中,提高查找消息的效率,同时减少磁盘 IO 操作;

  3. Kafka 将消息追加的操作逻辑变成为日志数据文件的顺序写入,极大的提高了磁盘 IO 的性能;

问:讲一下 Kafka 集群的 Leader 选举机制。

Kafka 在 Zookeeper 上针对每个 Topic 都维护了一个 ISR(in - sync replica ---已同步的副本)的集合,集合的增减 Kafka 都会更新该记录。如果某分区的 Leader 不可用, Kafka 就从 ISR 集合中选择一个副本作为新的 Leader。

分库分表

问:数据库如何处理海量数据?

分库分表,主从架构,读写分离。

问:数据库分库分表,何时分?怎么分?

水平分库/分表,垂直分库/分表。

  • 水平分库/表,各个库和表的结构一模一样。

  • 垂直分库/表,各个库和表的结构不一样。

问:读写分离怎么做?

主机负责写,从机负责读。

系统设计

1、分布式、高并发场景

遇到高并发场景,可以使用 Redis 缓存、Redis 限流、MQ 异步、MQ 削峰等。

问:在实践中,遇到过哪些并发的业务场景?

秒杀。比如抢商品,抢红包。

2、秒杀

问:如何设计一个秒杀/抢券系统?

  • 可以通过队列配合异步处理实现秒杀。

  • 使用 redis 的 list ,将商品 push 进队列, pop 出队列。

  • 异步操作不会阻塞,不会消耗太多时间。

问:如何提高抢券系统的性能?

  • 使用多个 list。

  • 使用多线程从队列中拉取数据。

  • 集群提高可用性。

  • MQ 异步处理,削峰。

问:秒杀怎么避免少卖或超卖?

redis 是单进程单线程的,操作具有原子性,不会导致少卖或者超卖。另外,也可以设置一个版本号 version ,乐观锁机制。

问:考勤打卡,假如高峰期有几万人同时打卡,那么怎么应对这种高并发?

使用 Redis 缓存。员工点击签到,可以在缓存中 set 状态。将工号作为 key ,打卡状态作为 value ,打卡成功为 01 ,未打卡或者打卡失败为 00 ,然后再将数据异步地写入到数据库里面就可以了。

问:如何应对高峰期的超高并发量?

Redis 限流。Redis 可以用计数器限流。使用 INCR 命令,每次都加一,处理完业务逻辑就减一。然后设置一个最大值,当达到最大值后就直接返回,不处理后续的逻辑。

Redis 还可以用令牌桶限流。使用 Redis 队列,每十个数据中 push 一个令牌桶,每个请求进入后会先从队列中 pop 数据,如果是令牌就可以通行,不是令牌就直接返回。

3、短链接 问:如何将长链接转换成短链接,并发送短信?

短 URL 从生成到使用分为以下几步:

  • 有一个服务,将要发送给你的长 URL 对应到一个短 URL 上.例如 www.baidu.com -> www.t.cn/1。

  • 把短 url 拼接到短信等的内容上发送。

  • 用户点击短 URL ,浏览器用 301 / 302 进行重定向,访问到对应的长 URL。

  • 展示对应的内容。

问:长链接和短链接如何互相转换?

思路是建立一个发号器。每次有一个新的长 URL 进来,我们就增加一。并且将新的数值返回.第一个来的 url 返回"www.x.cn/0",第二个返回"www.x.cn/1". 问:长链接和短链接的对应关系如何存储?

如果数据量小且 QPS 低,直接使用数据库的自增主键就可以实现。 还可以将最近/最热门的对应关系存储在 K-V 数据库中,这样子可以节省空间的同时,加快响应速度。

系统架构与设计

问:如何提高系统的并发能力?

  • 使用分布式系统。

  • 部署多台服务器,并做负载均衡。

  • 使用缓存(Redis)集群。

  • 数据库分库分表 + 读写分离。

  • 引入消息中间件集群。

问:设计一个红包系统,需要考虑哪些问题,如何解决?(本质上也是秒杀系统)

问:如果让你设计一个消息队列,你会怎么设计?

项目经验及数据量 问:这个项目的亮点、难点在哪里?

问:如果这个模块挂掉了怎么办? 问:你们的项目有多少台机器?

问:你们的项目有多少个实例?

  4 个实例。

问:你们的系统 QPS(TPS)是多少?

QPS ,每秒查询量。QPS 为几百/几千,已经算是比较高的了。 TPS ,每秒处理事务数。TPS 即每秒处理事务数,包括:"用户请求服务器"、"服务器自己的内部处理"、"服务器返回给用户",这三个过程,每秒能够完成 N 个这三个过程, TPS 也就是 3。

问:一个接口,多少秒响应才正常?

快的话几毫秒。慢的话 1-2 秒。异常情况可能会 10 几秒;最好保证 99 %以上的请求是正常的。

问:这个接口的请求时间,大概多久?主要耗时在哪里? 问:系统的数据量多少?有没有分库分表?

正常情况下,几百万的数据量没有必要分库分表。只有超过几千万才需要分库分表。

问:插入/更新一条数据要多久?更新十万/百万条数据要多久?

插入/更新一条数据一般要几毫秒;更新十万条数据最好在 10 秒以内; 百万条数据最好在 50-100 秒以内。


原文转载:http://www.shaoqun.com/a/504543.html

跨境电商:https://www.ikjzd.com/

焦点科技:https://www.ikjzd.com/w/1831

zappos:https://www.ikjzd.com/w/330


分布式分为分布式缓存(Redis)、分布式锁(Redis或Zookeeper)、分布式服务(Dubbo或SpringCloud)、分布式服务协调(Zookeeper)、分布式消息队列(Kafka、RabbitMq)、分布式Session、分布式事务、分布式搜索(Elasticsearch)等。不可能所有分布式内容都熟悉,一定要在某个领域有所专长。分布式理论问:分布式有哪些理论?CAP、BASE。分
agora:agora
启明星软件:启明星软件
亚马逊12月3日前停止收货?可能吗?:亚马逊12月3日前停止收货?可能吗?
吉林雾凇冰雪节2020 吉林雾凇冰雪节时间地点攻略:吉林雾凇冰雪节2020 吉林雾凇冰雪节时间地点攻略
香格里拉旅游注意事项?:香格里拉旅游注意事项?